
שיתוף | מה חדש בבינה מלאכותית - מתעדכן
-
הושק Kimi K3.1 Pro עם ציונים טובים מאוד
פרטים נוספים על Moonshot AI • Kimi K3.1 Pro
חברת Moonshot AI הסינית משחררת את Kimi K3.1 Pro, מודל הדגל החדש שלה, המהווה שדרוג משמעותי ל-Kimi K3 ומתחרה ישירות במודלים הסגורים המובילים של OpenAI ואנת'רופיק.
המודל מבוסס על ארכיטקטורת MoE הכוללת כ-2.8 טריליון פרמטרים, מתוכם 104 מיליארד פעילים בכל טוקן, והוא מציג שיפורים ניכרים ביכולות תכנות, הפעלת סוכנים, יצירת מודלים תלת-ממדיים ומשימות מקצועיות מורכבות.
עיקרי החידושים:
- אימון RL בהיקף נרחב: הגדלה משמעותית של משאבי האימון לאחר ה-Pre-training, עם אימון על מאות סוגי משימות וסביבות עבודה. החברה מדווחת על שיפורים נרחבים ביכולות המודל, ללא שינוי מהותי בארכיטקטורה הבסיסית של K3.
- תכנות ופיתוח פרויקטים: יכולות מתקדמות בפיתוח פרויקטים שלמים, עבודה עם בסיסי קוד, תיקון תקלות ושימוש בכלים. המודל מסוגל לפתח משחקים וסביבות אינטראקטיביות באמצעות Unity, Unreal Engine ו-Godot.
- יצירת מודלים תלת-ממדיים: יכולת ליצור ולערוך מודלים ב-Blender ובתוכנות CAD, באמצעות כתיבה והרצה של סקריפטים. החברה השיקה גם את Kimi 3D Make, המאפשר ליצור מודלים מתיאור טקסטואלי או מתמונה, ולייצא אותם להדפסת תלת-ממד.
- משימות פיננסיות ומשרדיות: שיפור בניתוח מסמכים פיננסיים, בניית גיליונות חישוב, מחקר השקעות וביצוע תהליכים מורכבים הכוללים הצלבת מידע ממקורות שונים.
- דיוק עובדתי: במבחן פנימי של החברה, שיעור הטענות השגויות ירד מ-23.4% בדור הקודם ל-8.3% בגרסה החדשה, שיפור של כ-65%.
- יכולות מולטימודליות והקשר ארוך: תמיכה בקלט של טקסט, תמונות ווידאו, לצד חלון הקשר של מיליון טוקנים.
- גרסת Highspeed: לצד המודל הרגיל הושקה גרסה מהירה במיוחד, המספקת מהירות גבוהה פי 2-3, עם אותן יכולות בסיסיות.
מדדים:
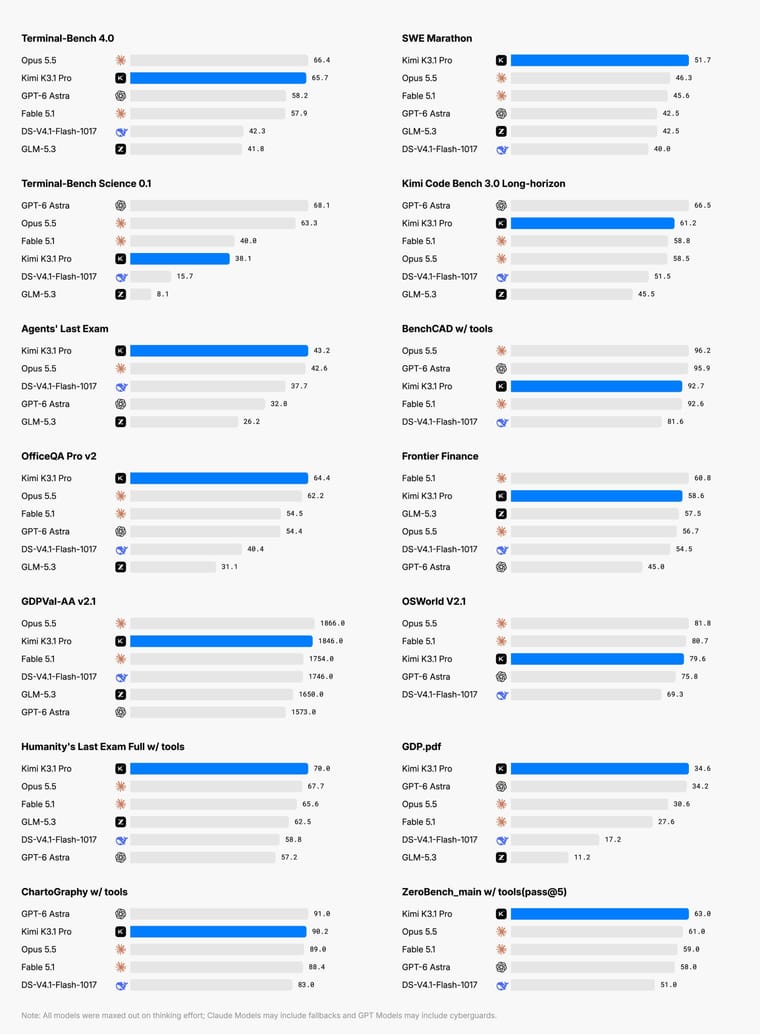
על פי המדדים שפרסמה Moonshot, המודל מתחרה ישירות ב-Claude Opus 5.5 וב-GPT-6 Astra, ואף מוביל בחלק ממבחני הסוכנים והתכנות.- Terminal-Bench 4.0: ציון 65.7, לעומת 66.4 של Claude Opus 5.5 ו-58.2 של GPT-6 Astra.
- SWE-Marathon: ציון 51.7, לעומת 46.3 של Claude Opus 5.5.
- BrowseComp: ציון 92.1, לעומת 90.8 של Claude Opus 5.5.
- HLE עם כלים: ציון 70, לעומת 67.7 של Claude Opus 5.5.
- BenchCAD: ציון 92.7 ביצירת מודלים תלת-ממדיים באמצעות כלים.
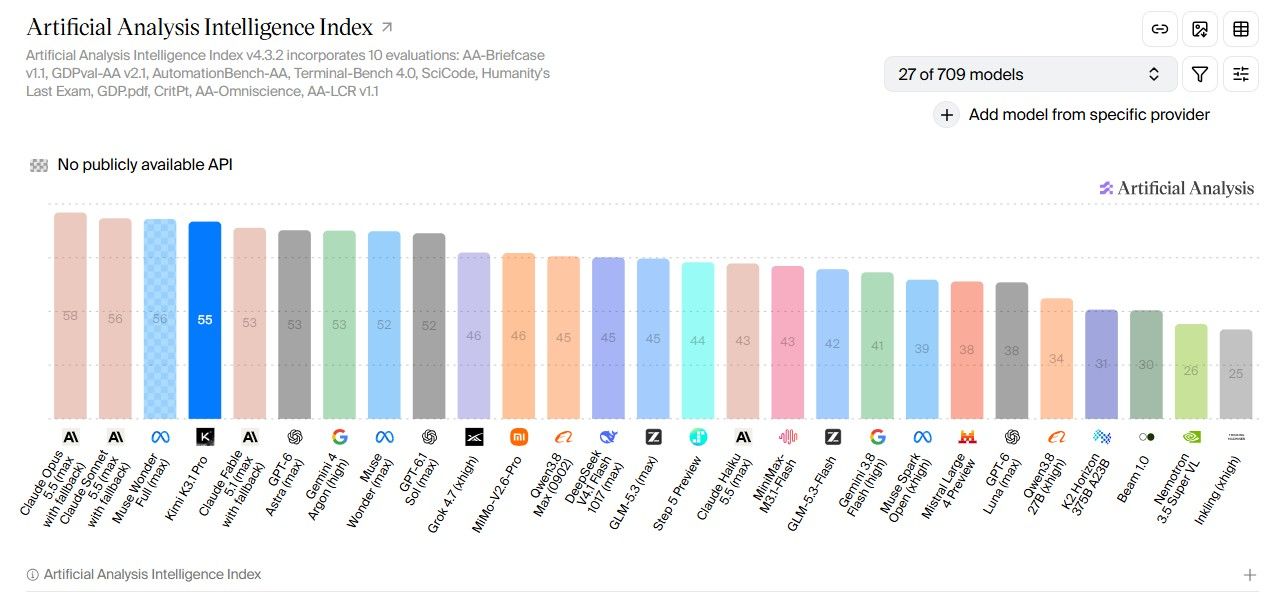
גם במדדים העצמאיים של Artificial Analysis המודל מציג תוצאות מרשימות במיוחד, עם ציון 55 במדד Intelligence Index, לעומת 58 ל-Claude Opus 5.5. מדובר באחד הציונים הגבוהים ביותר שנמדדו למודל המיועד לשחרור במשקלים פתוחים.
עם זאת, במבחנים מסוימים, בעיקר בתכנות מדעי ובפתרון בעיות מורכבות, המודלים הסגורים עדיין מציגים יתרון משמעותי.
ניתן לראות את המדדים הויזואליים שהעלה @יוסף-מאיר-וייס
 .
זמינות ומחירים:
המודל זמין כבר כעת באתר Kimi, ב-Kimi Code, ב-Kimi Work וב-API הרשמי.מחיר השימוש ב-API:
- קלט: 2 דולר למיליון טוקנים.
- פלט: 10 דולר למיליון טוקנים.
- קלט ממטמון: 0.20 דולר למיליון טוקנים.
גרסת Highspeed עולה 4 דולר למיליון טוקני קלט ו-20 דולר למיליון טוקני פלט.
המשקלים עדיין לא פורסמו, אך החברה התחייבה לשחרר אותם עד 4 בנובמבר 2026. עד לפרסומם אין גרסת GGUF זמינה של המודל החדש.
קישורים:
- הודעת השחרור הרשמית והמדדים:
https://www.kimi.com/en/blog/kimi-k3-1-pro - עמוד המודלים של Moonshot ב-Hugging Face, לקראת פרסום המשקלים:
https://huggingface.co/moonshotai - התנסות במודל:
https://www.kimi.com/
-
OpenAI ו-Google משתפות פעולה - מודלי GPT-6 מגיעים ל-Google Cloud ול-Antigravity!
כבר עכשיו המודלים זמינים ללקוחות ארגוניים, ובהמשך הגישה תיפתח לכלל המנויים.
מקורות:
https://openai.com/index/openai-models-google-cloud/
https://cloud.google.com/blog/products/ai-machine-learning/google-cloud-brings-openai-models-to-customersמפתח אפליקציות אנדרואיד ויישומי ומודלי AI
-
משתמשי נטפרי בגיפיטי?
מעתה יתווסף לכם על אתרים/תוכנות שתעשו בגיפיטי
הזרקה של ההודעה הבאה:
-
מאחר ובכל פעם שיוצא מודל או כלי AI חדש, או עדכון כלשהו למודל קיים מייד תוך כמה שעות מישהו ידאג להעלות נושא חדש עם ציטוט ארוך מאתר טכנולוגיה מזדמן המבשר באריכות על השקת המודל ויכולותיו, חשבתי פשוט ליצור נושא מתעדכן שבו יוכלו המשתמשים להעלות פוסטים קצרים ומתומצתים אודות המודלים החדשים והעדכונים, כך שכל המידע יהיה מרוכז במקום אחד, בקצרה ללא צורך לצטט כתבות שלמות כדי להצדיק פתיחת נושא חדש, ובכך למנוע הספמה של הפורום, כשלעיתים נפתחים במקביל 3 ויותר נושאים המבשרים על השקת מודל חדש...
נא לא להגיב על פוסטים אלא להעלות אך ורק עדכוני AI על מודלים וכלים חדשים וכדומה, בניסוח אנושי ומתומצת בלבד, בלי לפתוח דיונים.
מומלץ להגדיר את הנושא "במעקב" כדי להתעדכן מייד על כל פוסט שעולה.פוסט זה נמחק! -
משתמשי נטפרי בגיפיטי?
מעתה יתווסף לכם על אתרים/תוכנות שתעשו בגיפיטי
הזרקה של ההודעה הבאה: -
פוסט זה נמחק!
-
משתמשי נטפרי בגיפיטי?
מעתה יתווסף לכם על אתרים/תוכנות שתעשו בגיפיטי
הזרקה של ההודעה הבאה: -
OpenAI קיצרה פי 12 את זמן קריאת הנתונים מאחורי ChatGPT
OpenAI חושפת כיצד הרחיבה את פלטפורמת האחסון Habitat, המבוססת על Azure Cosmos DB ומחזיקה יותר מ-500 פטה-בייט. אחרי מעבר מריבוי דיירים לבידוד וחזרה, שיתוף פעולה הנדסי הדוק עם מיקרוסופט, שכבת מטמון ושכתוב ב-Rust הורידו את זמן הקריאה החציוני מכ-120 לכ-10 אלפיות שנייה. בהמשך מתוכננת מערכת אחסון פנימית בקנה מידה של אקסה-בייט.
פרטים מלאים בספויילר:
מאחורי כל שיחה ב-ChatGPT עומדת פלטפורמת אחסון פנימית בשם Habitat, שנדרשת להגיב בתוך אלפיות שנייה ליותר ממיליארד משתמשים ב-40 אזורים גאוגרפיים, ומחזיקה כיום יותר מ-500 פטה-בייט של נתונים. בפוסט הנדסי חדש, החלק השני בסדרה, מתארים מהנדסי OpenAI כיצד הרחיבו את רכיב האחסון שבבסיס הפלטפורמה: מסד הנתונים Azure Cosmos DB של מיקרוסופט. החלק הראשון עסק במעבר של Habitat מספריית לקוח בשפת Python לשירות עצמאי.
לפי החברה, סדר העדיפויות היה קבוע: קודם אמינות לתעבורה קריטית, אחר כך ביצועים למשתמשים ברחבי העולם, ולבסוף יעילות תפעולית בקנה מידה עצום.
בשלב הראשון כל העומסים רוכזו במכל (container) משותף אחד בכל חשבון, בהסתמך על מגבלת 10,000 יחידות בקשה לשנייה לכל מפתח מחיצה לוגי. בפועל, המגבלה נאכפת ברמת המחיצה הפיזית, כך שמפתחות שונים שחולקים מחיצה פיזית פגעו זה בזה. עומסים של פיצ'רים שוליים שיבשו לעיתים תהליכי התחברות והרשמה. בעיה נוספת: כשהנתונים גדלים, מחיצות מתפצלות והתפוקה הזמינה לכל מחיצה מצטמצמת, גם אם היקף הבקשות לא השתנה.
בשלב השני עברה OpenAI למכלים ייעודיים לכל שירות או פיצ'ר מרכזי. הבידוד צמצם תקלות כלל-אתריות, אבל הוליד בעיה ארגונית: כל צוות מוצר נדרש לתכנן קיבולת בעצמו. השקה שקפצה מאלף בקשות בבדיקות עומס למיליון בקשות ביום ההשקה יכלה לבלוע 5% מהמרווח במכל משותף גדול, אך לחרוג פי מאה מקיבולת מכל ייעודי קטן. לדברי המחברים, צוותים שכחו להגדיל מראש את הקיבולת, והמהנדסים מצאו את עצמם בחדרי תקלות ביום ההשקה.
בשלב השלישי חזרה החברה לריבוי דיירים כברירת מחדל, הפעם עם פתרונות שפותחו יחד עם צוות Azure: האטה של המפתחות החמים ביותר קודם, תיעדוף בקשות כך שעומסים לא-מקוונים מואטים לפני בקשות של משתמשי קצה, ומצב serverless משופר שנבנה עבור OpenAI ומאפשר לכל מחיצה פיזית להגיע ל-10,000 יחידות בקשה ולהתפצל גם לפי צריכה ולא רק לפי נפח. לפי החברה, מאז לא נרשמו תקלות של רעש שכנים או הקצאה.
כששירות מנוהל מפסיק להיות מנוהל
החשבון הגדול ביותר של OpenAI ב-Cosmos DB מאחסן עשרות פטה-בייט ומשרת יותר מ-20 מיליון בקשות בשנייה, ולטענת החברה אין פריסה אחרת בהיקף כזה. בסוף 2024 הפסקת חשמל באזור ענן מרכזי חשפה שהעברה לאזור משני של החשבונות הגדולים נמשכת כמה שעות, תרחיש שלא נבדק בקנה מידה זה. כחודש לאחר מכן, החזרה לאזור המקורי גרמה לנחשול חיבורים שהפיל את שער הגישה של המסד.
בעקבות זאת עברו הצוותים למודל של הנדסה משותפת: ניטור משותף של כל השכבות, סביבת בדיקות בגודל ייצור, פיתוח משותף של ערכות פיתוח וערוץ ישיר להזעקת מהנדסים בלי לעבור דרך מוקדי תמיכה.
ירידה פי 12 בזמן התגובה:
קריאות מהוות יותר מ-90% מהבקשות ל-Habitat, ולכן המאמץ ב-2026 התמקד בהן. האסטרטגיה כוללת אחסון נתונים קרוב למשתמשים כשהקיבולת מאפשרת, שכפול נרחב רק של מאגרים קטנים ורגישים במיוחד כמו נתוני אימות, ושכבת מטמון מבוזרת מבוססת Valkey. כדי לשמור על רעננות המטמון, החברה נשענת על לכידת שינויים (CDC) מתוך מסד הנתונים, שמפיצה פקודות ביטול גלובליות בתוך שניות, בהשראת מערכת TAO של Meta. במקביל נכתב שירות Habitat מחדש ב-Rust במקום Python.
התוצאה: זמן התגובה החציוני לקריאות ירד מכ-120 אלפיות שנייה לכ-10 אלפיות שנייה. מערך ה-CDC עצמו מעבד מיליוני שינויים בשנייה דרך יותר ממאה נושאי Kafka, ומזין גם אינדקסים משניים, צינורות העברת נתונים ואנליטיקה.
יותר מ-90%
שיעור הקריאות מכלל הבקשות ל-Habitat
כ-10 אלפיות שנייה
זמן התגובה החציוני לקריאות לאחר השיפור
מערכת אחסון פנימית בקנה מידה של אקסה-בייט
לקראת מיליארד המשתמשים הבא, OpenAI מפתחת מערכת אחסון פנימית בקנה מידה של אקסה-בייט, המיועדת לסוגי הנתונים הכבדים של Habitat. המערכת משלבת את ליבת RocksDB Cloud של Rockset עם שכפול מבוסס Raft, ושומרת על מודל המסמכים של Cosmos DB. לפי החברה, היא מפרידה בין אחסון לעיבוד ומשתמשת בשכפול פיזי כדי לחסוך בנפח זיכרון הבזק, במחיר של תפוקת שיא נמוכה יותר. -
פוסט זה נמחק!
-
Nanbeige • Nanbeige4.3-33B
צוות Nanbeige הסיני משחרר את Nanbeige4.3-33B, מודל שפה פתוח חדש בעל 33 מיליארד פרמטרים, המתמקד ביכולות תכנות, חשיבה והפעלת סוכני AI.
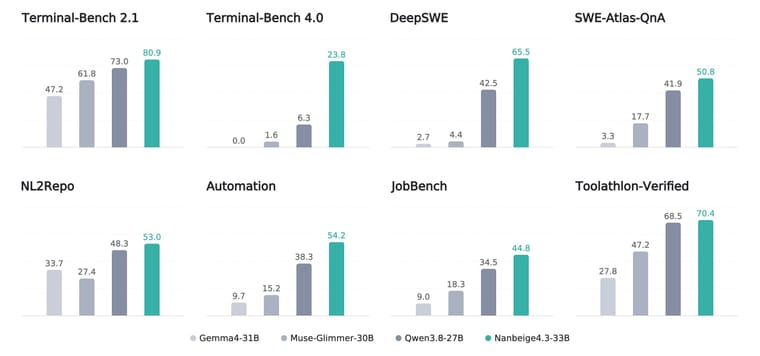
למרות גודלו הבינוני, המודל מציג ביצועים מרשימים במיוחד, ועל פי מדדי המפתחים הוא עוקף את Qwen3.8-27B ואת Gemma4-31B במרבית מבחני התכנות והסוכנים.
המודל החדש מיועד בעיקר כדי לשמש כמודל מורה לאימון מודלים קטנים באמצעות זיקוק, כאשר הצוות כבר מתכנן להשיק בהמשך גרסת 3B שתירש חלק מיכולותיו.
עיקרי החידושים:
- ארכיטקטורה: מודל צפוף המבוסס על ארכיטקטורת Llama, עם 33B פרמטרים הפעילים בכל טוקן, בניגוד למודלי MoE המפעילים רק חלק מהפרמטרים.
- יכולות תכנות: ביצועים גבוהים במיוחד בפיתוח תוכנה, תיקון תקלות, עבודה עם בסיסי קוד וביצוע משימות תכנות עצמאיות באמצעות סוכנים.
- יכולות סוכן: המודל אומן והותאם לביצוע משימות מקצועיות מורכבות, שימוש בכלים, אוטומציות משרדיות, חיפוש מידע ותכנון תהליכים מרובי שלבים.
- חלון הקשר: תמיכה בעד 512K טוקנים, המאפשרת עבודה עם מסמכים ארוכים, בסיסי קוד גדולים ומשימות ממושכות.
- שליטה ברמת החשיבה: אפשרות להפעיל או להשבית Reasoning באמצעות
enable_thinking, לצד אפשרות לשמר את תהליך החשיבה משיחות קודמות באמצעותpreserve_thinking. החברה ממליצה על האפשרות האחרונה בעיקר למשימות סוכניות ותכנות. - הפעלת כלים: תמיכה מובנית ב-Tool Calling, עם אפשרות לפורמט XML או JSON. לפי המפתחים, פורמט XML מספק את התוצאות הטובות ביותר.
- אימון מודלים קטנים: גרסת 33B תשמש כמודל מורה לסדרת מודלים קטנים יותר, ובראשם Nanbeige4.3-3B המתוכנן.
מדדים:
על פי הבדיקות שפרסמו המפתחים, המודל מציג יתרון משמעותי על פני מתחרים בגודל דומה:- Terminal-Bench 2.1: ציון 80.9, לעומת 73 של Qwen3.8-27B.
- DeepSWE: ציון 65.5, לעומת 42.5 של Qwen3.8-27B.
- SWE-Bench Pro: ציון 60.3, מעט מתחת ל-61.7 של Qwen3.8-27B.
- AutomationBench: ציון 54.2, לעומת 38.3 של Qwen3.8-27B.
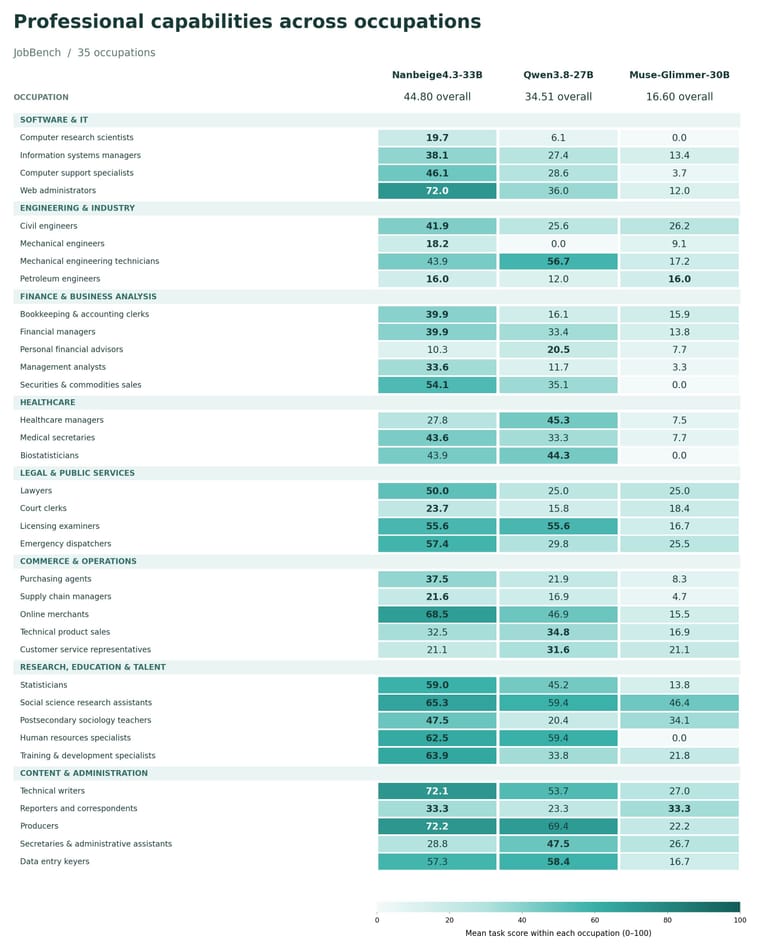
- JobBench: ציון 44.8, לעומת 34.5 של Qwen3.8-27B.
- DeepPlanning: ציון 63.3, לעומת 49.2 של Qwen3.8-27B.
- GPQA Diamond: ציון 89.5.
- AIME 2026: ציון 95.2.
בסך הכול, המודל מוביל ב-17 מתוך 20 המדדים שהציג הצוות, וב-18 מתוכם הוא עוקף את Qwen3.8-27B.
חשוב לציין כי מדובר במדדים שפרסמו המפתחים, וטרם פורסמו בדיקות עצמאיות מקיפות המאמתות את התוצאות.
זמינות:
המודל שוחרר במשקלים פתוחים תחת רישיון Apache 2.0, המאפשר גם שימוש מסחרי.זמינות שתי גרסאות רשמיות - גרסת Instruct עם יכולות חשיבה והפעלת כלים, וגרסת Base המיועדת לאימון ולהתאמות נוספות.
קיימת תמיכה בהרצה באמצעות Transformers, vLLM ו-SGLang, וכבר פורסמו גם גרסאות GGUF קהילתיות להרצה מקומית באמצעות llama.cpp ותוכנות תואמות.
בשל ארכיטקטורת ה-Dense, המודל דורש כ-20GB לאחסון המשקלים בכימות Q4, בנוסף לזיכרון הדרוש לחלון ההקשר.
קישורים:
- כרטיס המודל הרשמי והמדדים:
https://huggingface.co/Nanbeige/Nanbeige4.3-33B - גרסת Base:
https://huggingface.co/Nanbeige/Nanbeige4.3-33B-Base - גרסאות GGUF בכימותים שונים:
https://huggingface.co/AtomicChat/Nanbeige4.3-33B-GGUF



שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות { const baseUrl = "https://www.google.co.il/search?q=site:mitmachim.top"; const m = location.pathname.match(/^\/(topic|category)\/(\d+)/); const type = m ? m[1] : null; const id = m ? m[2] : null; let searchInput; function search(path = "") { const query = searchInput.value.trim(); if (query) { window.open(`${baseUrl}${path}%20${encodeURIComponent(query)}`, "_blank"); } } let buttons = {}; buttons.searchAll = { id: "bb-search-all", label: `חיפוש ${type ? "בכל הפורום" : ""}`, className: type ? "btn-secondary" : "btn-primary", callback: () => search(), }; if (type === "topic") { buttons.searchTopic = { label: "חיפוש בנושא זה", className: "btn-primary", callback: () => search(`/topic/${id}`), }; } else if (type === "category") { buttons.searchCategory = { label: "חיפוש בקטגוריה זו", className: "btn-primary", callback: () => search(`/category/${id}`), }; } buttons.cancel = { label: "ביטול", className: "btn-default", "data-bs-dismiss": "modal" }; const dialog = bootbox.dialog({ title: '<div style="text-align:center;"><img src="/assets/uploads/files/1625950269825-mt-google.png" width="400" alt="חיפוש בגוגל"></div>', message: '<input id="bb-inp" class="bootbox-input bootbox-input-text form-control" placeholder="הקלידו כדי לחפש בגוגל" autocomplete="off"/>', buttons, backdrop: true, show: true, onEscape: true }); dialog.on("shown.bs.modal", function () { searchInput = document.getElementById("bb-inp"); if (searchInput) { searchInput.focus(); searchInput.addEventListener("keydown", function (e) { if (e.key === "Enter") { e.preventDefault(); const query = this.value.trim(); if (query) { search(); dialog.modal("hide"); } } else if (e.key === "Escape") { e.preventDefault(); dialog.modal("hide"); } }); } const searchAllButton = document.getElementById("bb-search-all"); if (searchAllButton) { searchAllButton.title = "לחצו על אנטר כדי לחפש"; } }); })(); void 0;)