
להורדה | SparkMoE גרסה V0.4.2 - הרצת מודלי שפה גדולים על חומרה חלשה! עדכון י"א תשרי תשפ"ז
-
-
@טכנופוב יש קבצי קוונטיזציה רשמיים של Qwen עצמם, אבל הכי מומלצים זה של Unsloth.
בכימותים של 4 ביט, המודל שוקל בסביבות ה-24 GB.
כמובן, כל כימות נתמך.
בפוסט שחרור הגרסה הראשונה שמתי קישורים מדוייקים למודלים המומלצים. -
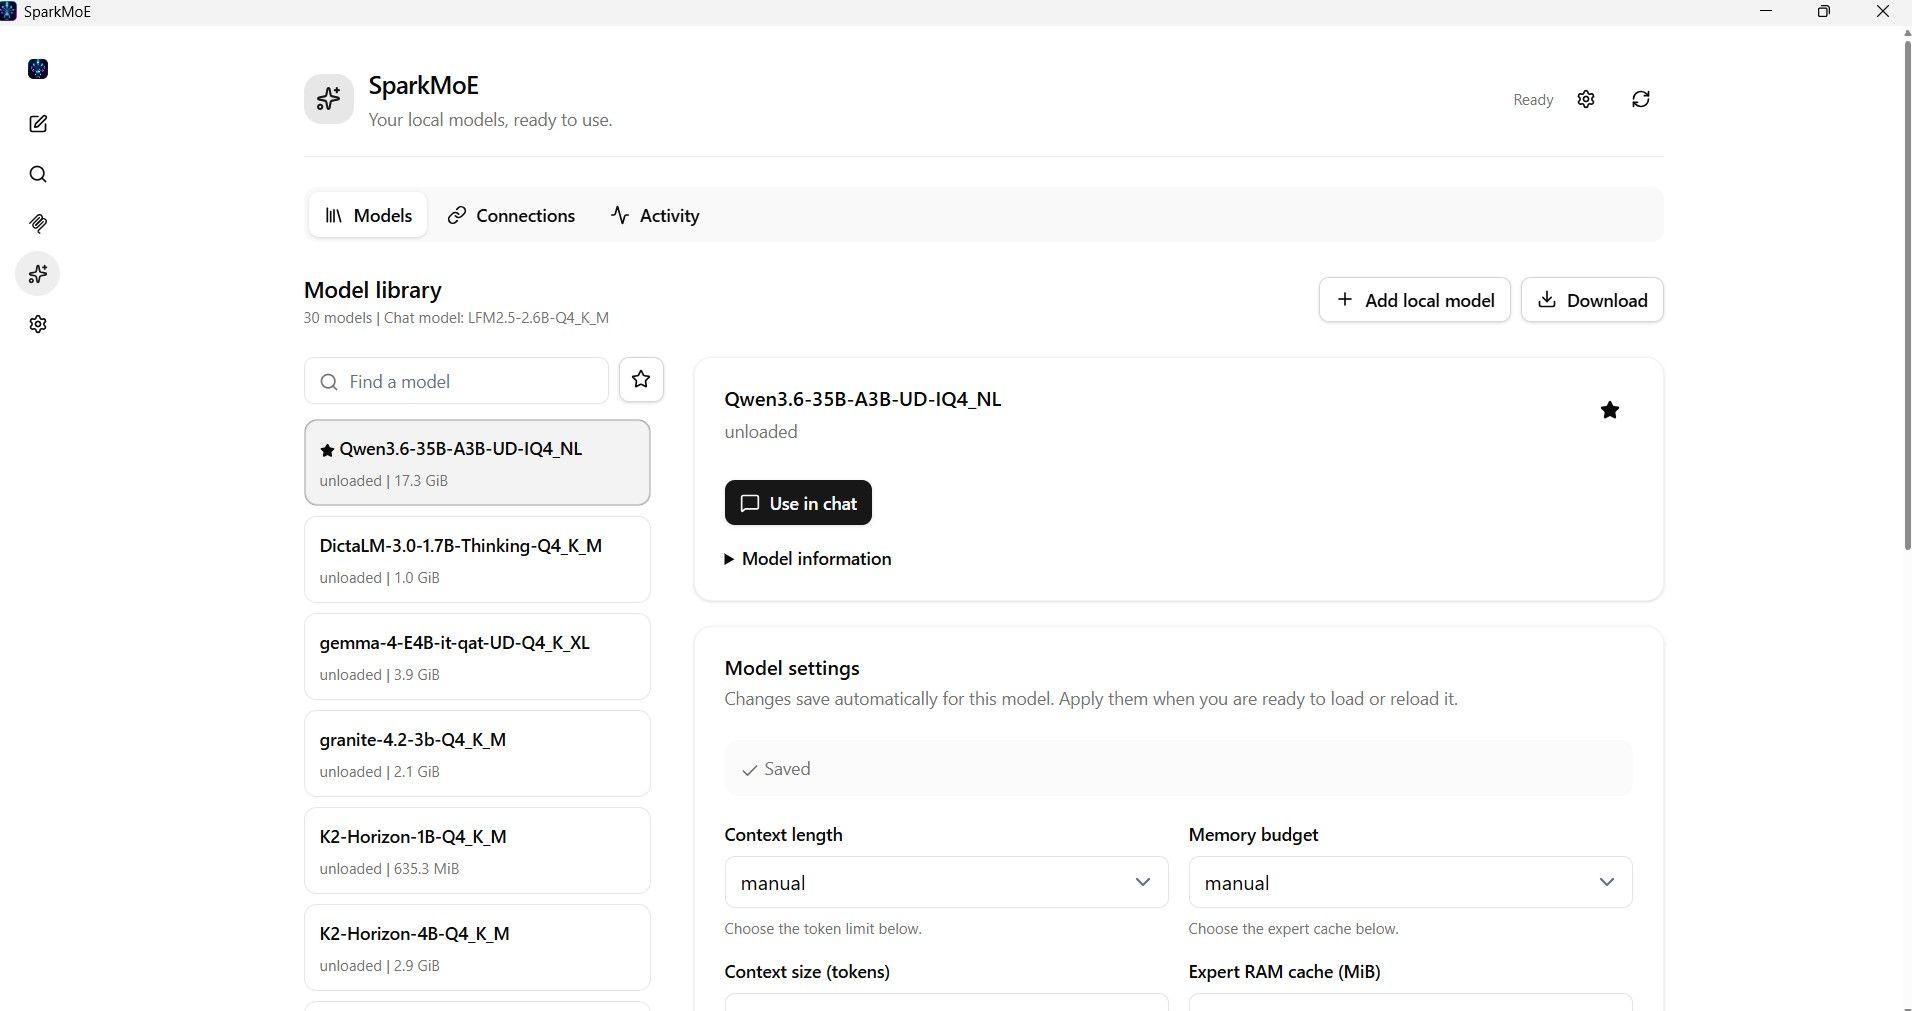
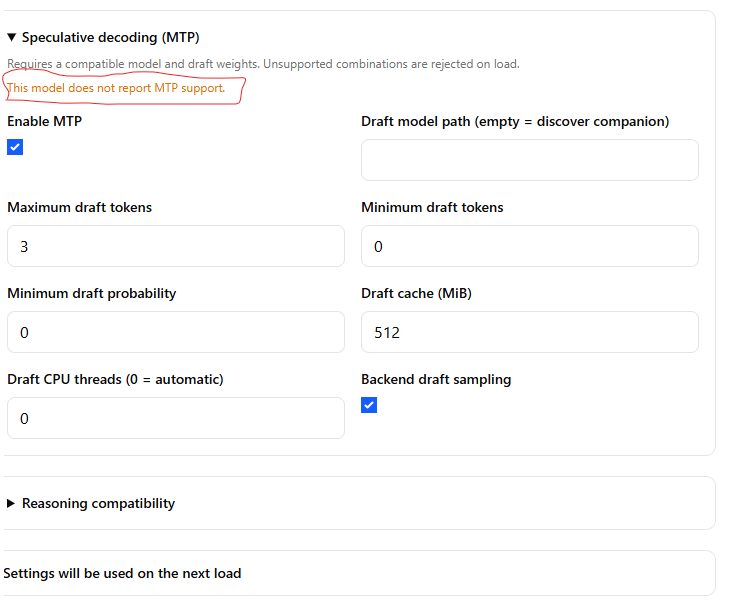
@א.מ.ד. הורדתי על פי המלצתך https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MTP-GGUF/blob/main/Qwen3.6-35B-A3B-UD-IQ4_NL.gguf ולמרות שזה מודל MTP התוכנה לא מזהה אותו ככזה
-
@א.מ.ד. הורדתי על פי המלצתך https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MTP-GGUF/blob/main/Qwen3.6-35B-A3B-UD-IQ4_NL.gguf ולמרות שזה מודל MTP התוכנה לא מזהה אותו ככזה
תתעלם מזה.
-
??[2026-11-05 13:32:21] SparkMoE 0.4.2-alpha session started
[2026-11-05 13:32:21] SparkMoE: Notification area icon ready
0.00.010.474 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the-lv NCLI arg)
0.00.015.207 I srv load_models: Loaded 0 cached model presets
0.00.017.942 I srv load_models: Loaded 2 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
0.00.018.342 I srv operator (): Available models (2) (: custom preset)
0.00.018.350 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
0.00.018.353 I srv operator (): * qwen3.6-35b-a3b-ud-iq4-nl (aliases: Qwen3.6-35B-A3B-UD-IQ4_NL)
0.00.018.583 W srv llama_server: -----------------
0.00.018.585 W srv llama_server: CORS is set to allow all origins ('') and no API key is set
0.00.018.586 W srv llama_server: this can be a security risk (cross-origin attacks)
0.00.018.588 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
0.00.018.590 W srv llama_server: -----------------
0.00.018.617 W srv llama_server: -----------------
0.00.018.619 W srv llama_server: the following feature(s) are enabled:
0.00.018.621 W srv llama_server: router mode
0.00.018.623 W srv llama_server: do not expose the server to untrusted environments
0.00.018.625 W srv llama_server: -----------------
0.00.018.648 I srv llama_server: starting server in router mode. models will be automatically loaded on-demand
0.00.024.982 I srv llama_server: listening on http://127.0.0.1:8080
0.00.024.991 W srv llama_server: NOTICE: server default port will be changed to :9931 in a future release
0.00.024.991 W srv llama_server: ref: https://github.com/ggml-org/llama.cpp/pull/26508
[2026-11-05 13:32:22] SparkMoE: desktop: navigation ready
[2026-11-05 13:32:36] SparkMoE: desktop: navigation ready
0.22.848.693 I srv load_models: Loaded 0 cached model presets
0.22.855.660 I srv load_models: Loaded 1 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
0.22.855.744 I srv load_models: (reload) removing model name=qwen3.6-35b-a3b-ud-iq4-nl (no longer in source)
0.22.855.878 I srv operator (): Available models (1) (*: custom preset)
0.22.855.884 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
0.22.859.514 I srv load: spawning server instance with name=lfm3-1.7b-q4-k-m on port 51264
0.22.859.629 I srv load: spawning server instance with args:
0.22.859.630 I srv load: C:\Users\User\Downloads\sparkmoe-0.4.2-alpha-windows-x64-avx2\llama-server.exe
0.22.859.631 I srv load: --context-shift
0.22.859.634 I srv load: --host
0.22.859.636 I srv load: 127.0.0.1
0.22.859.637 I srv load: --log-colors
0.22.859.638 I srv load: off
0.22.859.639 I srv load: --log-timestamps
0.22.859.640 I srv load: --metrics
0.22.859.641 I srv load: --moe-cache-mib
0.22.859.642 I srv load: 3885
0.22.859.643 I srv load: --moe-cache-policy
0.22.859.643 I srv load: lru
0.22.859.645 I srv load: --moe-dense-residency
0.22.859.645 I srv load: auto
0.22.859.646 I srv load: --moe-io-mode
0.22.859.647 I srv load: buffered
0.22.859.648 I srv load: --moe-io-threads
0.22.859.648 I srv load: 1
0.22.859.649 I srv load: --moe-overlap
0.22.859.650 I srv load: off
0.22.859.651 I srv load: --moe-paged-layers
0.22.859.651 I srv load: 0
0.22.859.653 I srv load: --moe-paging
0.22.859.653 I srv load: auto
0.22.859.654 I srv load: --moe-ple-cache-mib
0.22.859.655 I srv load: 64
0.22.859.655 I srv load: --moe-prefetch
0.22.859.666 I srv load: off
0.22.859.667 I srv load: --port
0.22.859.668 I srv load: 51264
0.22.859.669 I srv load: --spec-type
0.22.859.670 I srv load: none
0.22.859.670 I srv load: --alias
0.22.859.671 I srv load: lfm3-1.7b-q4-k-m
0.22.859.673 I srv load: --batch-size
0.22.859.674 I srv load: 1024
0.22.859.675 I srv load: --ctx-size
0.22.859.676 I srv load: 8192
0.22.859.677 I srv load: --cache-ram
0.22.859.677 I srv load: 0
0.22.859.678 I srv load: --cache-type-k
0.22.859.679 I srv load: f16
0.22.859.680 I srv load: --cache-type-v
0.22.859.681 I srv load: f16
0.22.859.682 I srv load: --swa-checkpoints
0.22.859.683 I srv load: 4
0.22.859.684 I srv load: --model
0.22.859.685 I srv load: C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf
0.22.859.685 I srv load: --n-gpu-layers
0.22.859.686 I srv load: 0
0.22.859.687 I srv load: --parallel
0.22.859.687 I srv load: 1
0.22.859.688 I srv load: --reasoning
0.22.859.689 I srv load: auto
0.22.859.690 I srv load: --ubatch-size
0.22.859.691 I srv load: 84
[51264] warning: no usable GPU found, --gpu-layers option will be ignored[51264] warning: one possible reason is that llama.cpp was compiled without GPU support
[51264] warning: consult docs/build.md for compilation instructions
[51264] 0.00.010.942 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the
-lv NCLI arg)[51264] 0.00.011.462 W srv llama_server: -----------------
[51264] 0.00.011.467 W srv llama_server: CORS is set to allow all origins ('*') and no API key is set
[51264] 0.00.011.468 W srv llama_server: this can be a security risk (cross-origin attacks)
[51264] 0.00.011.469 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
[51264] 0.00.011.470 W srv llama_server: -----------------
[51264] 0.00.020.172 I srv load_model: loading model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51264] 0.00.020.187 I MoE paging auto selected explicit mode because a cache limit was provided
[51264] 0.00.347.346 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51264] 0.00.347.354 E llama_model_load_from_file_impl: failed to load model
[51264] 0.00.347.414 E common_fit_params: encountered an error while trying to fit params to free device memory: failed to load model
[51264] 0.00.614.568 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51264] 0.00.614.579 E llama_model_load_from_file_impl: failed to load model
[51264] 0.00.614.582 W cmn common_init_: MoE paging auto could not use explicit expert paging; retrying with standard mmap loading
[51264] 0.00.905.861 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51264] 0.00.905.994 E llama_model_load_from_file_impl: failed to load model
[51264] 0.00.906.003 E cmn common_init_: failed to load model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51264] 0.00.906.022 E srv load_model: failed to load model, 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51264] 0.00.906.031 I srv operator (): operator (): cleaning up before exit...
[51264] 0.00.906.681 E srv llama_server: exiting due to model loading error
0.23.835.161 I srv operator (): instance name=lfm3-1.7b-q4-k-m exited with status 1
0.27.648.072 I srv load_models: Loaded 0 cached model presets
0.27.661.480 I srv load_models: Loaded 1 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
0.27.661.693 I srv operator (): Available models (1) (*: custom preset)
0.27.661.711 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
0.27.663.948 I srv load: spawning server instance with name=lfm3-1.7b-q4-k-m on port 51277
0.27.664.006 I srv load: spawning server instance with args:
0.27.664.011 I srv load: C:\Users\User\Downloads\sparkmoe-0.4.2-alpha-windows-x64-avx2\llama-server.exe
0.27.664.012 I srv load: --context-shift
0.27.664.013 I srv load: --host
0.27.664.014 I srv load: 127.0.0.1
0.27.664.015 I srv load: --log-colors
0.27.664.015 I srv load: off
0.27.664.019 I srv load: --log-timestamps
0.27.664.020 I srv load: --metrics
0.27.664.021 I srv load: --moe-cache-mib
0.27.664.022 I srv load: 3880
0.27.664.024 I srv load: --moe-cache-policy
0.27.664.024 I srv load: lru
0.27.664.025 I srv load: --moe-dense-residency
0.27.664.026 I srv load: auto
0.27.664.026 I srv load: --moe-io-mode
0.27.664.027 I srv load: buffered
0.27.664.028 I srv load: --moe-io-threads
0.27.664.028 I srv load: 1
0.27.664.029 I srv load: --moe-overlap
0.27.664.030 I srv load: off
0.27.664.030 I srv load: --moe-paged-layers
0.27.664.031 I srv load: 0
0.27.664.032 I srv load: --moe-paging
0.27.664.033 I srv load: auto
0.27.664.033 I srv load: --moe-ple-cache-mib
0.27.664.034 I srv load: 64
0.27.664.035 I srv load: --moe-prefetch
0.27.664.035 I srv load: off
0.27.664.036 I srv load: --port
0.27.664.037 I srv load: 51277
0.27.664.037 I srv load: --spec-type
0.27.664.038 I srv load: none
0.27.664.039 I srv load: --alias
0.27.664.039 I srv load: lfm3-1.7b-q4-k-m
0.27.664.040 I srv load: --batch-size
0.27.664.041 I srv load: 1024
0.27.664.041 I srv load: --ctx-size
0.27.664.045 I srv load: 8192
0.27.664.046 I srv load: --cache-ram
0.27.664.047 I srv load: 0
0.27.664.047 I srv load: --cache-type-k
0.27.664.048 I srv load: f16
0.27.664.049 I srv load: --cache-type-v
0.27.664.049 I srv load: f16
0.27.664.050 I srv load: --swa-checkpoints
0.27.664.050 I srv load: 4
0.27.664.051 I srv load: --model
0.27.664.052 I srv load: C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf
0.27.664.053 I srv load: --n-gpu-layers
0.27.664.053 I srv load: 0
0.27.664.054 I srv load: --parallel
0.27.664.055 I srv load: 1
0.27.664.055 I srv load: --reasoning
0.27.664.056 I srv load: auto
0.27.664.057 I srv load: --ubatch-size
0.27.664.057 I srv load: 84
[51277] warning: no usable GPU found, --gpu-layers option will be ignored[51277] warning: one possible reason is that llama.cpp was compiled without GPU support
[51277] warning: consult docs/build.md for compilation instructions
[51277] 0.00.011.508 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the
-lv NCLI arg)[51277] 0.00.012.083 W srv llama_server: -----------------
[51277] 0.00.012.087 W srv llama_server: CORS is set to allow all origins ('*') and no API key is set
[51277] 0.00.012.088 W srv llama_server: this can be a security risk (cross-origin attacks)
[51277] 0.00.012.088 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
[51277] 0.00.012.088 W srv llama_server: -----------------
[51277] 0.00.020.710 I srv load_model: loading model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51277] 0.00.020.728 I MoE paging auto selected explicit mode because a cache limit was provided
[51277] 0.00.314.188 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51277] 0.00.314.198 E llama_model_load_from_file_impl: failed to load model
[51277] 0.00.314.266 E common_fit_params: encountered an error while trying to fit params to free device memory: failed to load model
[51277] 0.00.612.703 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51277] 0.00.612.716 E llama_model_load_from_file_impl: failed to load model
[51277] 0.00.612.720 W cmn common_init_: MoE paging auto could not use explicit expert paging; retrying with standard mmap loading
[51277] 0.00.890.146 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51277] 0.00.890.155 E llama_model_load_from_file_impl: failed to load model
[51277] 0.00.890.159 E cmn common_init_: failed to load model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51277] 0.00.890.172 E srv load_model: failed to load model, 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51277] 0.00.890.179 I srv operator (): operator (): cleaning up before exit...
[51277] 0.00.890.913 E srv llama_server: exiting due to model loading error
0.28.628.314 I srv operator (): instance name=lfm3-1.7b-q4-k-m exited with status 1
[2026-11-05 13:33:41] SparkMoE: desktop: navigation failed HRESULT=0x800704d4
1.28.773.310 I srv load_models: Loaded 0 cached model presets
1.28.788.371 I srv load_models: Loaded 1 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
1.28.788.600 I srv operator (): Available models (1) (*: custom preset)
1.28.788.609 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
1.28.792.378 I srv load: spawning server instance with name=lfm3-1.7b-q4-k-m on port 51334
1.28.792.459 I srv load: spawning server instance with args:
1.28.792.460 I srv load: C:\Users\User\Downloads\sparkmoe-0.4.2-alpha-windows-x64-avx2\llama-server.exe
1.28.792.461 I srv load: --context-shift
1.28.792.462 I srv load: --host
1.28.792.462 I srv load: 127.0.0.1
1.28.792.463 I srv load: --log-colors
1.28.792.464 I srv load: off
1.28.792.465 I srv load: --log-timestamps
1.28.792.467 I srv load: --metrics
1.28.792.469 I srv load: --moe-cache-mib
1.28.792.470 I srv load: 4150
1.28.792.472 I srv load: --moe-cache-policy
1.28.792.474 I srv load: lru
1.28.792.476 I srv load: --moe-dense-residency
1.28.792.478 I srv load: auto
1.28.792.479 I srv load: --moe-io-mode
1.28.792.481 I srv load: buffered
1.28.792.483 I srv load: --moe-io-threads
1.28.792.485 I srv load: 1
1.28.792.487 I srv load: --moe-overlap
1.28.792.488 I srv load: off
1.28.792.490 I srv load: --moe-paged-layers
1.28.792.492 I srv load: 0
1.28.792.494 I srv load: --moe-paging
1.28.792.496 I srv load: auto
1.28.792.498 I srv load: --moe-ple-cache-mib
1.28.792.500 I srv load: 64
1.28.792.502 I srv load: --moe-prefetch
1.28.792.503 I srv load: off
1.28.792.506 I srv load: --port
1.28.792.507 I srv load: 51334
1.28.792.509 I srv load: --spec-type
1.28.792.511 I srv load: none
1.28.792.512 I srv load: --alias
1.28.792.513 I srv load: lfm3-1.7b-q4-k-m
1.28.792.514 I srv load: --batch-size
1.28.792.515 I srv load: 1024
1.28.792.516 I srv load: --ctx-size
1.28.792.517 I srv load: 8192
1.28.792.518 I srv load: --cache-ram
1.28.792.519 I srv load: 0
1.28.792.520 I srv load: --cache-type-k
1.28.792.520 I srv load: f16
1.28.792.521 I srv load: --cache-type-v
1.28.792.522 I srv load: f16
1.28.792.523 I srv load: --swa-checkpoints
1.28.792.523 I srv load: 4
1.28.792.524 I srv load: --model
1.28.792.525 I srv load: C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf
1.28.792.526 I srv load: --n-gpu-layers
1.28.792.526 I srv load: 0
1.28.792.527 I srv load: --parallel
1.28.792.528 I srv load: 1
1.28.792.529 I srv load: --reasoning
1.28.792.529 I srv load: auto
1.28.792.530 I srv load: --ubatch-size
1.28.792.531 I srv load: 88
1.28.809.798 I srv ensure_model: waiting until model name=lfm3-1.7b-q4-k-m is fully loaded...
[51334] warning: no usable GPU found, --gpu-layers option will be ignored[51334] warning: one possible reason is that llama.cpp was compiled without GPU support
[51334] warning: consult docs/build.md for compilation instructions
[51334] 0.00.012.767 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the
-lv NCLI arg)[51334] 0.00.013.309 W srv llama_server: -----------------
[51334] 0.00.013.314 W srv llama_server: CORS is set to allow all origins ('*') and no API key is set
[51334] 0.00.013.314 W srv llama_server: this can be a security risk (cross-origin attacks)
[51334] 0.00.013.315 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
[51334] 0.00.013.315 W srv llama_server: -----------------
[51334] 0.00.019.311 I srv load_model: loading model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51334] 0.00.019.330 I MoE paging auto selected explicit mode because a cache limit was provided
[51334] 0.00.361.572 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51334] 0.00.361.593 E llama_model_load_from_file_impl: failed to load model
[51334] 0.00.361.662 E common_fit_params: encountered an error while trying to fit params to free device memory: failed to load model
[51334] 0.00.695.686 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51334] 0.00.695.767 E llama_model_load_from_file_impl: failed to load model
[51334] 0.00.695.809 W cmn common_init_: MoE paging auto could not use explicit expert paging; retrying with standard mmap loading
[51334] 0.01.027.943 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51334] 0.01.027.957 E llama_model_load_from_file_impl: failed to load model
[51334] 0.01.027.961 E cmn common_init_: failed to load model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51334] 0.01.027.978 E srv load_model: failed to load model, 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51334] 0.01.027.987 I srv operator (): operator (): cleaning up before exit...
[51334] 0.01.028.651 E srv llama_server: exiting due to model loading error
1.29.891.377 I srv operator (): instance name=lfm3-1.7b-q4-k-m exited with status 1
1.29.891.661 W srv operator (): got exception: {"error":{"code":500,"message":"model name=lfm3-1.7b-q4-k-m failed to load","type":"server_error"}} -
??[2026-11-05 13:32:21] SparkMoE 0.4.2-alpha session started
[2026-11-05 13:32:21] SparkMoE: Notification area icon ready
0.00.010.474 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the-lv NCLI arg)
0.00.015.207 I srv load_models: Loaded 0 cached model presets
0.00.017.942 I srv load_models: Loaded 2 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
0.00.018.342 I srv operator (): Available models (2) (: custom preset)
0.00.018.350 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
0.00.018.353 I srv operator (): * qwen3.6-35b-a3b-ud-iq4-nl (aliases: Qwen3.6-35B-A3B-UD-IQ4_NL)
0.00.018.583 W srv llama_server: -----------------
0.00.018.585 W srv llama_server: CORS is set to allow all origins ('') and no API key is set
0.00.018.586 W srv llama_server: this can be a security risk (cross-origin attacks)
0.00.018.588 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
0.00.018.590 W srv llama_server: -----------------
0.00.018.617 W srv llama_server: -----------------
0.00.018.619 W srv llama_server: the following feature(s) are enabled:
0.00.018.621 W srv llama_server: router mode
0.00.018.623 W srv llama_server: do not expose the server to untrusted environments
0.00.018.625 W srv llama_server: -----------------
0.00.018.648 I srv llama_server: starting server in router mode. models will be automatically loaded on-demand
0.00.024.982 I srv llama_server: listening on http://127.0.0.1:8080
0.00.024.991 W srv llama_server: NOTICE: server default port will be changed to :9931 in a future release
0.00.024.991 W srv llama_server: ref: https://github.com/ggml-org/llama.cpp/pull/26508
[2026-11-05 13:32:22] SparkMoE: desktop: navigation ready
[2026-11-05 13:32:36] SparkMoE: desktop: navigation ready
0.22.848.693 I srv load_models: Loaded 0 cached model presets
0.22.855.660 I srv load_models: Loaded 1 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
0.22.855.744 I srv load_models: (reload) removing model name=qwen3.6-35b-a3b-ud-iq4-nl (no longer in source)
0.22.855.878 I srv operator (): Available models (1) (*: custom preset)
0.22.855.884 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
0.22.859.514 I srv load: spawning server instance with name=lfm3-1.7b-q4-k-m on port 51264
0.22.859.629 I srv load: spawning server instance with args:
0.22.859.630 I srv load: C:\Users\User\Downloads\sparkmoe-0.4.2-alpha-windows-x64-avx2\llama-server.exe
0.22.859.631 I srv load: --context-shift
0.22.859.634 I srv load: --host
0.22.859.636 I srv load: 127.0.0.1
0.22.859.637 I srv load: --log-colors
0.22.859.638 I srv load: off
0.22.859.639 I srv load: --log-timestamps
0.22.859.640 I srv load: --metrics
0.22.859.641 I srv load: --moe-cache-mib
0.22.859.642 I srv load: 3885
0.22.859.643 I srv load: --moe-cache-policy
0.22.859.643 I srv load: lru
0.22.859.645 I srv load: --moe-dense-residency
0.22.859.645 I srv load: auto
0.22.859.646 I srv load: --moe-io-mode
0.22.859.647 I srv load: buffered
0.22.859.648 I srv load: --moe-io-threads
0.22.859.648 I srv load: 1
0.22.859.649 I srv load: --moe-overlap
0.22.859.650 I srv load: off
0.22.859.651 I srv load: --moe-paged-layers
0.22.859.651 I srv load: 0
0.22.859.653 I srv load: --moe-paging
0.22.859.653 I srv load: auto
0.22.859.654 I srv load: --moe-ple-cache-mib
0.22.859.655 I srv load: 64
0.22.859.655 I srv load: --moe-prefetch
0.22.859.666 I srv load: off
0.22.859.667 I srv load: --port
0.22.859.668 I srv load: 51264
0.22.859.669 I srv load: --spec-type
0.22.859.670 I srv load: none
0.22.859.670 I srv load: --alias
0.22.859.671 I srv load: lfm3-1.7b-q4-k-m
0.22.859.673 I srv load: --batch-size
0.22.859.674 I srv load: 1024
0.22.859.675 I srv load: --ctx-size
0.22.859.676 I srv load: 8192
0.22.859.677 I srv load: --cache-ram
0.22.859.677 I srv load: 0
0.22.859.678 I srv load: --cache-type-k
0.22.859.679 I srv load: f16
0.22.859.680 I srv load: --cache-type-v
0.22.859.681 I srv load: f16
0.22.859.682 I srv load: --swa-checkpoints
0.22.859.683 I srv load: 4
0.22.859.684 I srv load: --model
0.22.859.685 I srv load: C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf
0.22.859.685 I srv load: --n-gpu-layers
0.22.859.686 I srv load: 0
0.22.859.687 I srv load: --parallel
0.22.859.687 I srv load: 1
0.22.859.688 I srv load: --reasoning
0.22.859.689 I srv load: auto
0.22.859.690 I srv load: --ubatch-size
0.22.859.691 I srv load: 84
[51264] warning: no usable GPU found, --gpu-layers option will be ignored[51264] warning: one possible reason is that llama.cpp was compiled without GPU support
[51264] warning: consult docs/build.md for compilation instructions
[51264] 0.00.010.942 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the
-lv NCLI arg)[51264] 0.00.011.462 W srv llama_server: -----------------
[51264] 0.00.011.467 W srv llama_server: CORS is set to allow all origins ('*') and no API key is set
[51264] 0.00.011.468 W srv llama_server: this can be a security risk (cross-origin attacks)
[51264] 0.00.011.469 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
[51264] 0.00.011.470 W srv llama_server: -----------------
[51264] 0.00.020.172 I srv load_model: loading model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51264] 0.00.020.187 I MoE paging auto selected explicit mode because a cache limit was provided
[51264] 0.00.347.346 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51264] 0.00.347.354 E llama_model_load_from_file_impl: failed to load model
[51264] 0.00.347.414 E common_fit_params: encountered an error while trying to fit params to free device memory: failed to load model
[51264] 0.00.614.568 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51264] 0.00.614.579 E llama_model_load_from_file_impl: failed to load model
[51264] 0.00.614.582 W cmn common_init_: MoE paging auto could not use explicit expert paging; retrying with standard mmap loading
[51264] 0.00.905.861 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51264] 0.00.905.994 E llama_model_load_from_file_impl: failed to load model
[51264] 0.00.906.003 E cmn common_init_: failed to load model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51264] 0.00.906.022 E srv load_model: failed to load model, 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51264] 0.00.906.031 I srv operator (): operator (): cleaning up before exit...
[51264] 0.00.906.681 E srv llama_server: exiting due to model loading error
0.23.835.161 I srv operator (): instance name=lfm3-1.7b-q4-k-m exited with status 1
0.27.648.072 I srv load_models: Loaded 0 cached model presets
0.27.661.480 I srv load_models: Loaded 1 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
0.27.661.693 I srv operator (): Available models (1) (*: custom preset)
0.27.661.711 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
0.27.663.948 I srv load: spawning server instance with name=lfm3-1.7b-q4-k-m on port 51277
0.27.664.006 I srv load: spawning server instance with args:
0.27.664.011 I srv load: C:\Users\User\Downloads\sparkmoe-0.4.2-alpha-windows-x64-avx2\llama-server.exe
0.27.664.012 I srv load: --context-shift
0.27.664.013 I srv load: --host
0.27.664.014 I srv load: 127.0.0.1
0.27.664.015 I srv load: --log-colors
0.27.664.015 I srv load: off
0.27.664.019 I srv load: --log-timestamps
0.27.664.020 I srv load: --metrics
0.27.664.021 I srv load: --moe-cache-mib
0.27.664.022 I srv load: 3880
0.27.664.024 I srv load: --moe-cache-policy
0.27.664.024 I srv load: lru
0.27.664.025 I srv load: --moe-dense-residency
0.27.664.026 I srv load: auto
0.27.664.026 I srv load: --moe-io-mode
0.27.664.027 I srv load: buffered
0.27.664.028 I srv load: --moe-io-threads
0.27.664.028 I srv load: 1
0.27.664.029 I srv load: --moe-overlap
0.27.664.030 I srv load: off
0.27.664.030 I srv load: --moe-paged-layers
0.27.664.031 I srv load: 0
0.27.664.032 I srv load: --moe-paging
0.27.664.033 I srv load: auto
0.27.664.033 I srv load: --moe-ple-cache-mib
0.27.664.034 I srv load: 64
0.27.664.035 I srv load: --moe-prefetch
0.27.664.035 I srv load: off
0.27.664.036 I srv load: --port
0.27.664.037 I srv load: 51277
0.27.664.037 I srv load: --spec-type
0.27.664.038 I srv load: none
0.27.664.039 I srv load: --alias
0.27.664.039 I srv load: lfm3-1.7b-q4-k-m
0.27.664.040 I srv load: --batch-size
0.27.664.041 I srv load: 1024
0.27.664.041 I srv load: --ctx-size
0.27.664.045 I srv load: 8192
0.27.664.046 I srv load: --cache-ram
0.27.664.047 I srv load: 0
0.27.664.047 I srv load: --cache-type-k
0.27.664.048 I srv load: f16
0.27.664.049 I srv load: --cache-type-v
0.27.664.049 I srv load: f16
0.27.664.050 I srv load: --swa-checkpoints
0.27.664.050 I srv load: 4
0.27.664.051 I srv load: --model
0.27.664.052 I srv load: C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf
0.27.664.053 I srv load: --n-gpu-layers
0.27.664.053 I srv load: 0
0.27.664.054 I srv load: --parallel
0.27.664.055 I srv load: 1
0.27.664.055 I srv load: --reasoning
0.27.664.056 I srv load: auto
0.27.664.057 I srv load: --ubatch-size
0.27.664.057 I srv load: 84
[51277] warning: no usable GPU found, --gpu-layers option will be ignored[51277] warning: one possible reason is that llama.cpp was compiled without GPU support
[51277] warning: consult docs/build.md for compilation instructions
[51277] 0.00.011.508 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the
-lv NCLI arg)[51277] 0.00.012.083 W srv llama_server: -----------------
[51277] 0.00.012.087 W srv llama_server: CORS is set to allow all origins ('*') and no API key is set
[51277] 0.00.012.088 W srv llama_server: this can be a security risk (cross-origin attacks)
[51277] 0.00.012.088 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
[51277] 0.00.012.088 W srv llama_server: -----------------
[51277] 0.00.020.710 I srv load_model: loading model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51277] 0.00.020.728 I MoE paging auto selected explicit mode because a cache limit was provided
[51277] 0.00.314.188 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51277] 0.00.314.198 E llama_model_load_from_file_impl: failed to load model
[51277] 0.00.314.266 E common_fit_params: encountered an error while trying to fit params to free device memory: failed to load model
[51277] 0.00.612.703 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51277] 0.00.612.716 E llama_model_load_from_file_impl: failed to load model
[51277] 0.00.612.720 W cmn common_init_: MoE paging auto could not use explicit expert paging; retrying with standard mmap loading
[51277] 0.00.890.146 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51277] 0.00.890.155 E llama_model_load_from_file_impl: failed to load model
[51277] 0.00.890.159 E cmn common_init_: failed to load model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51277] 0.00.890.172 E srv load_model: failed to load model, 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51277] 0.00.890.179 I srv operator (): operator (): cleaning up before exit...
[51277] 0.00.890.913 E srv llama_server: exiting due to model loading error
0.28.628.314 I srv operator (): instance name=lfm3-1.7b-q4-k-m exited with status 1
[2026-11-05 13:33:41] SparkMoE: desktop: navigation failed HRESULT=0x800704d4
1.28.773.310 I srv load_models: Loaded 0 cached model presets
1.28.788.371 I srv load_models: Loaded 1 custom model presets from C:\Users\User\AppData\Local\SparkMoE\model-profiles.ini
1.28.788.600 I srv operator (): Available models (1) (*: custom preset)
1.28.788.609 I srv operator (): * lfm3-1.7b-q4-k-m (aliases: LFM3-1.7B-Q4_K_M)
1.28.792.378 I srv load: spawning server instance with name=lfm3-1.7b-q4-k-m on port 51334
1.28.792.459 I srv load: spawning server instance with args:
1.28.792.460 I srv load: C:\Users\User\Downloads\sparkmoe-0.4.2-alpha-windows-x64-avx2\llama-server.exe
1.28.792.461 I srv load: --context-shift
1.28.792.462 I srv load: --host
1.28.792.462 I srv load: 127.0.0.1
1.28.792.463 I srv load: --log-colors
1.28.792.464 I srv load: off
1.28.792.465 I srv load: --log-timestamps
1.28.792.467 I srv load: --metrics
1.28.792.469 I srv load: --moe-cache-mib
1.28.792.470 I srv load: 4150
1.28.792.472 I srv load: --moe-cache-policy
1.28.792.474 I srv load: lru
1.28.792.476 I srv load: --moe-dense-residency
1.28.792.478 I srv load: auto
1.28.792.479 I srv load: --moe-io-mode
1.28.792.481 I srv load: buffered
1.28.792.483 I srv load: --moe-io-threads
1.28.792.485 I srv load: 1
1.28.792.487 I srv load: --moe-overlap
1.28.792.488 I srv load: off
1.28.792.490 I srv load: --moe-paged-layers
1.28.792.492 I srv load: 0
1.28.792.494 I srv load: --moe-paging
1.28.792.496 I srv load: auto
1.28.792.498 I srv load: --moe-ple-cache-mib
1.28.792.500 I srv load: 64
1.28.792.502 I srv load: --moe-prefetch
1.28.792.503 I srv load: off
1.28.792.506 I srv load: --port
1.28.792.507 I srv load: 51334
1.28.792.509 I srv load: --spec-type
1.28.792.511 I srv load: none
1.28.792.512 I srv load: --alias
1.28.792.513 I srv load: lfm3-1.7b-q4-k-m
1.28.792.514 I srv load: --batch-size
1.28.792.515 I srv load: 1024
1.28.792.516 I srv load: --ctx-size
1.28.792.517 I srv load: 8192
1.28.792.518 I srv load: --cache-ram
1.28.792.519 I srv load: 0
1.28.792.520 I srv load: --cache-type-k
1.28.792.520 I srv load: f16
1.28.792.521 I srv load: --cache-type-v
1.28.792.522 I srv load: f16
1.28.792.523 I srv load: --swa-checkpoints
1.28.792.523 I srv load: 4
1.28.792.524 I srv load: --model
1.28.792.525 I srv load: C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf
1.28.792.526 I srv load: --n-gpu-layers
1.28.792.526 I srv load: 0
1.28.792.527 I srv load: --parallel
1.28.792.528 I srv load: 1
1.28.792.529 I srv load: --reasoning
1.28.792.529 I srv load: auto
1.28.792.530 I srv load: --ubatch-size
1.28.792.531 I srv load: 88
1.28.809.798 I srv ensure_model: waiting until model name=lfm3-1.7b-q4-k-m is fully loaded...
[51334] warning: no usable GPU found, --gpu-layers option will be ignored[51334] warning: one possible reason is that llama.cpp was compiled without GPU support
[51334] warning: consult docs/build.md for compilation instructions
[51334] 0.00.012.767 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the
-lv NCLI arg)[51334] 0.00.013.309 W srv llama_server: -----------------
[51334] 0.00.013.314 W srv llama_server: CORS is set to allow all origins ('*') and no API key is set
[51334] 0.00.013.314 W srv llama_server: this can be a security risk (cross-origin attacks)
[51334] 0.00.013.315 W srv llama_server: more info: https://github.com/ggml-org/llama.cpp/pull/25655
[51334] 0.00.013.315 W srv llama_server: -----------------
[51334] 0.00.019.311 I srv load_model: loading model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51334] 0.00.019.330 I MoE paging auto selected explicit mode because a cache limit was provided
[51334] 0.00.361.572 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51334] 0.00.361.593 E llama_model_load_from_file_impl: failed to load model
[51334] 0.00.361.662 E common_fit_params: encountered an error while trying to fit params to free device memory: failed to load model
[51334] 0.00.695.686 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51334] 0.00.695.767 E llama_model_load_from_file_impl: failed to load model
[51334] 0.00.695.809 W cmn common_init_: MoE paging auto could not use explicit expert paging; retrying with standard mmap loading
[51334] 0.01.027.943 E llama_model_load: error loading model: unknown model architecture: 'lfm3'
[51334] 0.01.027.957 E llama_model_load_from_file_impl: failed to load model
[51334] 0.01.027.961 E cmn common_init_: failed to load model 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51334] 0.01.027.978 E srv load_model: failed to load model, 'C:\Users\User\AppData\Local\SparkMoE\models\download-1\LFM3-1.7B-Q4_K_M.gguf'
[51334] 0.01.027.987 I srv operator (): operator (): cleaning up before exit...
[51334] 0.01.028.651 E srv llama_server: exiting due to model loading error
1.29.891.377 I srv operator (): instance name=lfm3-1.7b-q4-k-m exited with status 1
1.29.891.661 W srv operator (): got exception: {"error":{"code":500,"message":"model name=lfm3-1.7b-q4-k-m failed to load","type":"server_error"}} -
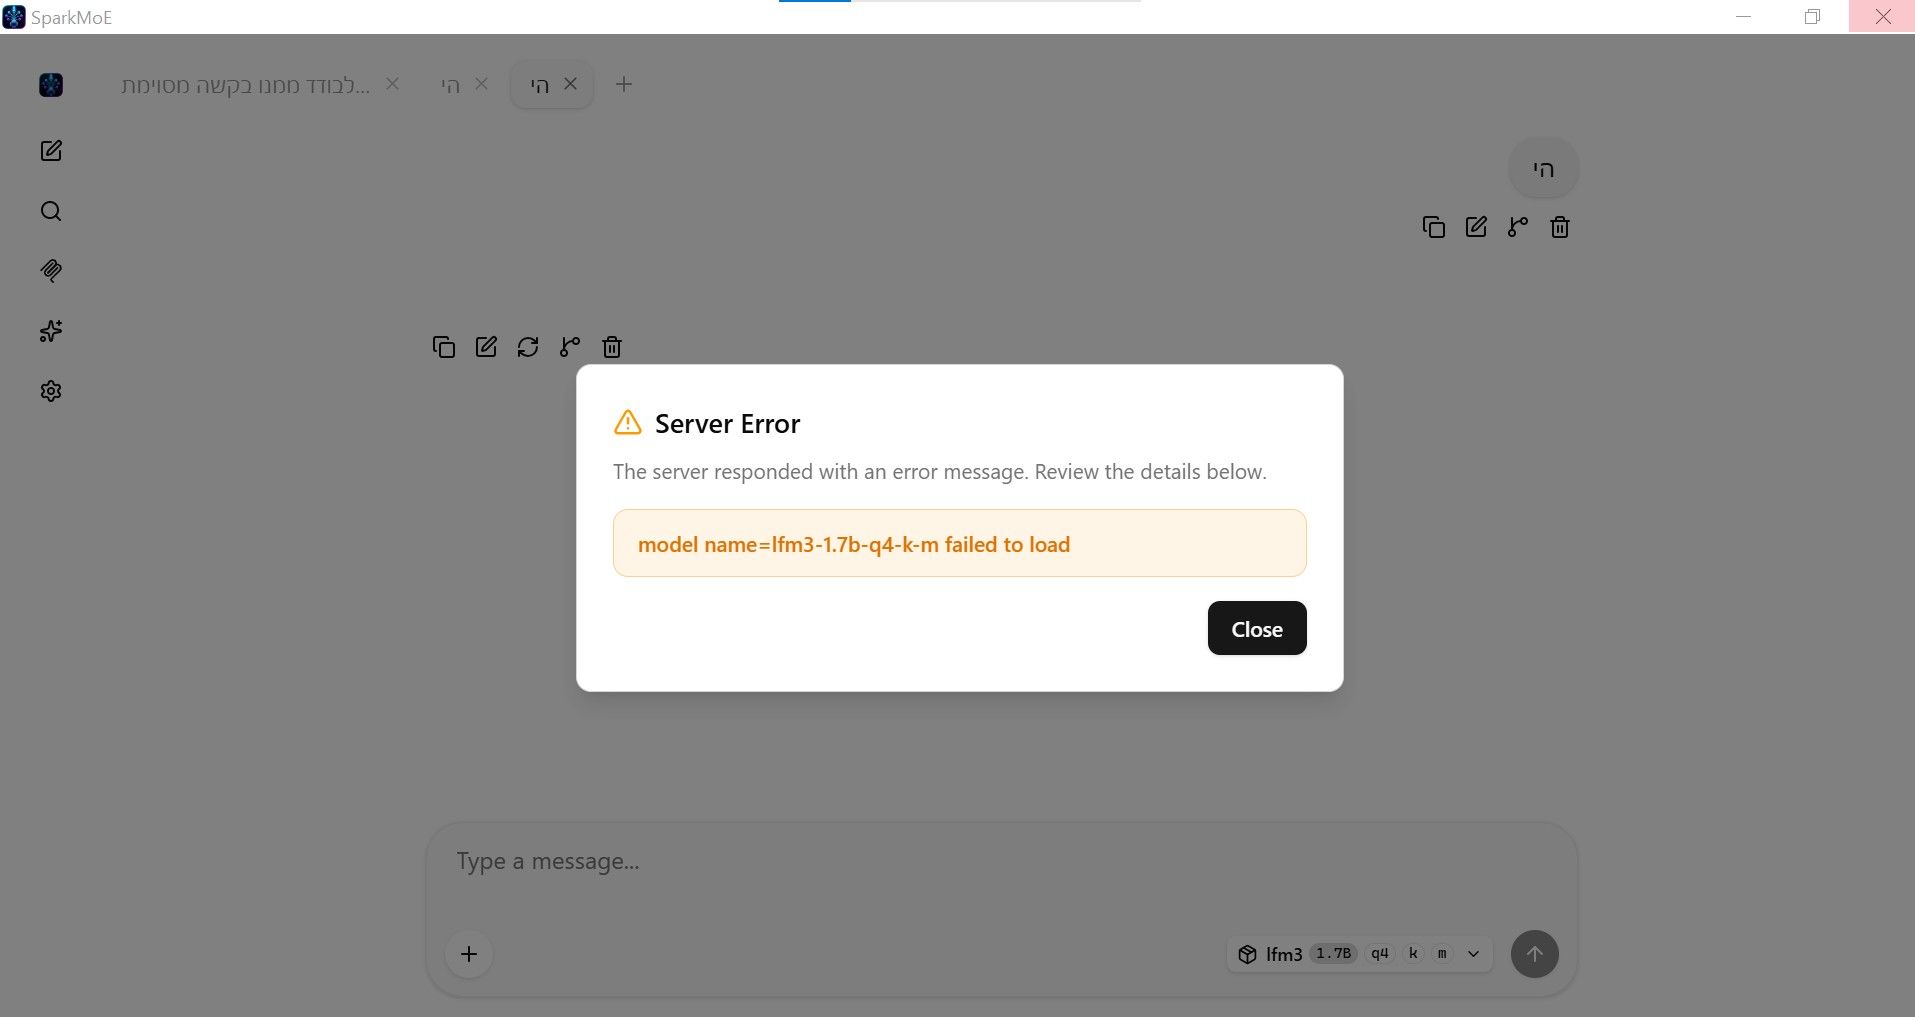
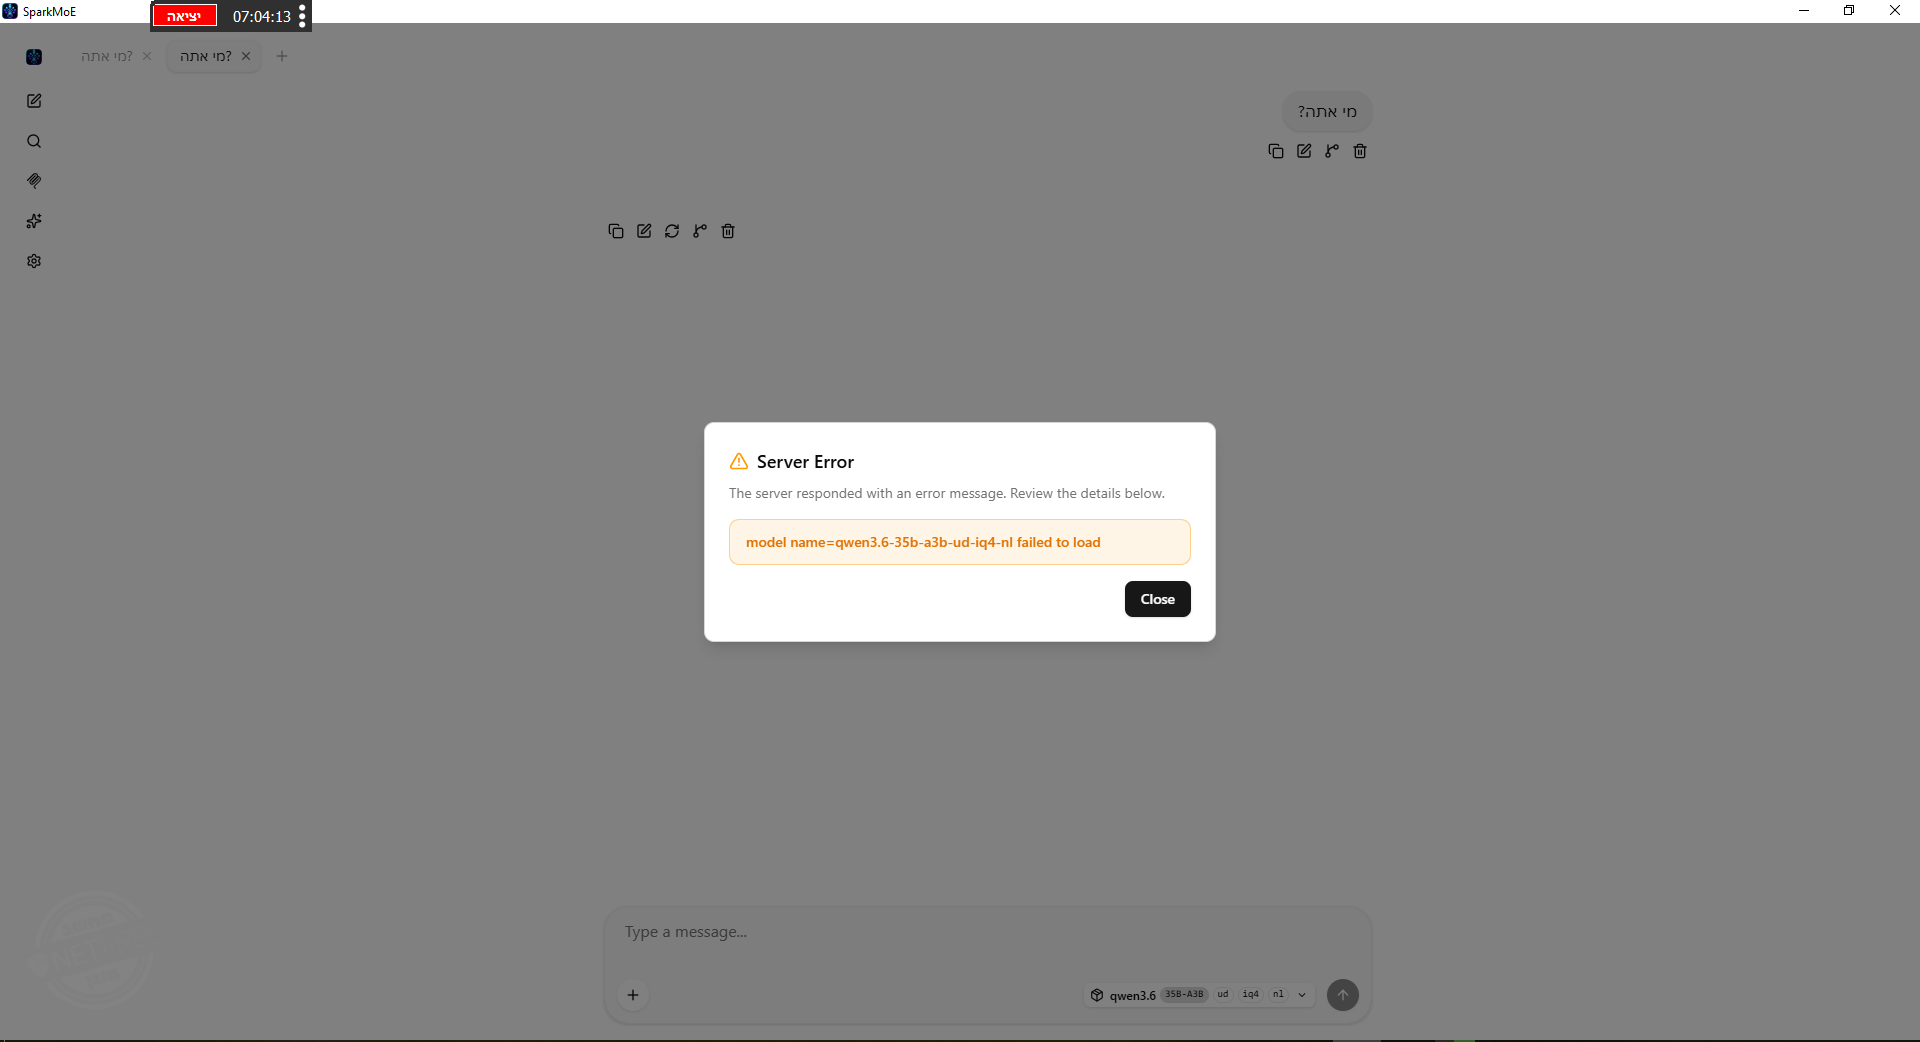
@עידו300 זה בגלל שהמודל הזה לא נתמך ב-SparkMoE בגרסה הנוכחית.
בגרסה הבאה של SparkMoE בעז"ה יהיה עדכון אוטומטי של מנוע llama.cpp.


שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות { const baseUrl = "https://www.google.co.il/search?q=site:mitmachim.top"; const m = location.pathname.match(/^\/(topic|category)\/(\d+)/); const type = m ? m[1] : null; const id = m ? m[2] : null; let searchInput; function search(path = "") { const query = searchInput.value.trim(); if (query) { window.open(`${baseUrl}${path}%20${encodeURIComponent(query)}`, "_blank"); } } let buttons = {}; buttons.searchAll = { id: "bb-search-all", label: `חיפוש ${type ? "בכל הפורום" : ""}`, className: type ? "btn-secondary" : "btn-primary", callback: () => search(), }; if (type === "topic") { buttons.searchTopic = { label: "חיפוש בנושא זה", className: "btn-primary", callback: () => search(`/topic/${id}`), }; } else if (type === "category") { buttons.searchCategory = { label: "חיפוש בקטגוריה זו", className: "btn-primary", callback: () => search(`/category/${id}`), }; } buttons.cancel = { label: "ביטול", className: "btn-default", "data-bs-dismiss": "modal" }; const dialog = bootbox.dialog({ title: '<div style="text-align:center;"><img src="/assets/uploads/files/1625950269825-mt-google.png" width="400" alt="חיפוש בגוגל"></div>', message: '<input id="bb-inp" class="bootbox-input bootbox-input-text form-control" placeholder="הקלידו כדי לחפש בגוגל" autocomplete="off"/>', buttons, backdrop: true, show: true, onEscape: true }); dialog.on("shown.bs.modal", function () { searchInput = document.getElementById("bb-inp"); if (searchInput) { searchInput.focus(); searchInput.addEventListener("keydown", function (e) { if (e.key === "Enter") { e.preventDefault(); const query = this.value.trim(); if (query) { search(); dialog.modal("hide"); } } else if (e.key === "Escape") { e.preventDefault(); dialog.modal("hide"); } }); } const searchAllButton = document.getElementById("bb-search-all"); if (searchAllButton) { searchAllButton.title = "לחצו על אנטר כדי לחפש"; } }); })(); void 0;)