
שיתוף | מה חדש בבינה מלאכותית - מתעדכן
-
פוסט זה נמחק!
-
Nanbeige • Nanbeige4.3-33B
צוות Nanbeige הסיני משחרר את Nanbeige4.3-33B, מודל שפה פתוח חדש בעל 33 מיליארד פרמטרים, המתמקד ביכולות תכנות, חשיבה והפעלת סוכני AI.
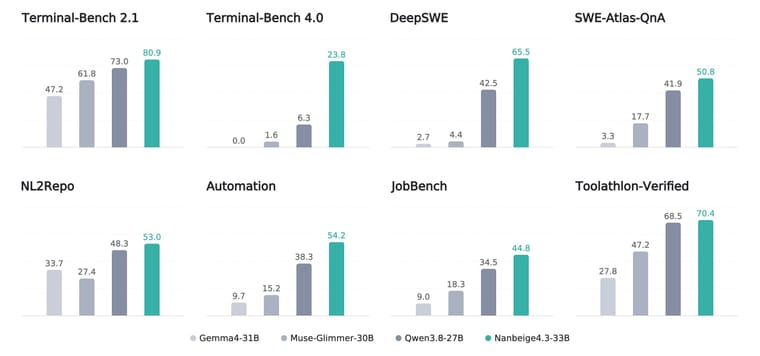
למרות גודלו הבינוני, המודל מציג ביצועים מרשימים במיוחד, ועל פי מדדי המפתחים הוא עוקף את Qwen3.8-27B ואת Gemma4-31B במרבית מבחני התכנות והסוכנים.
המודל החדש מיועד בעיקר כדי לשמש כמודל מורה לאימון מודלים קטנים באמצעות זיקוק, כאשר הצוות כבר מתכנן להשיק בהמשך גרסת 3B שתירש חלק מיכולותיו.
עיקרי החידושים:
- ארכיטקטורה: מודל צפוף המבוסס על ארכיטקטורת Llama, עם 33B פרמטרים הפעילים בכל טוקן, בניגוד למודלי MoE המפעילים רק חלק מהפרמטרים.
- יכולות תכנות: ביצועים גבוהים במיוחד בפיתוח תוכנה, תיקון תקלות, עבודה עם בסיסי קוד וביצוע משימות תכנות עצמאיות באמצעות סוכנים.
- יכולות סוכן: המודל אומן והותאם לביצוע משימות מקצועיות מורכבות, שימוש בכלים, אוטומציות משרדיות, חיפוש מידע ותכנון תהליכים מרובי שלבים.
- חלון הקשר: תמיכה בעד 512K טוקנים, המאפשרת עבודה עם מסמכים ארוכים, בסיסי קוד גדולים ומשימות ממושכות.
- שליטה ברמת החשיבה: אפשרות להפעיל או להשבית Reasoning באמצעות
enable_thinking, לצד אפשרות לשמר את תהליך החשיבה משיחות קודמות באמצעותpreserve_thinking. החברה ממליצה על האפשרות האחרונה בעיקר למשימות סוכניות ותכנות. - הפעלת כלים: תמיכה מובנית ב-Tool Calling, עם אפשרות לפורמט XML או JSON. לפי המפתחים, פורמט XML מספק את התוצאות הטובות ביותר.
- אימון מודלים קטנים: גרסת 33B תשמש כמודל מורה לסדרת מודלים קטנים יותר, ובראשם Nanbeige4.3-3B המתוכנן.
מדדים:
על פי הבדיקות שפרסמו המפתחים, המודל מציג יתרון משמעותי על פני מתחרים בגודל דומה:- Terminal-Bench 2.1: ציון 80.9, לעומת 73 של Qwen3.8-27B.
- DeepSWE: ציון 65.5, לעומת 42.5 של Qwen3.8-27B.
- SWE-Bench Pro: ציון 60.3, מעט מתחת ל-61.7 של Qwen3.8-27B.
- AutomationBench: ציון 54.2, לעומת 38.3 של Qwen3.8-27B.
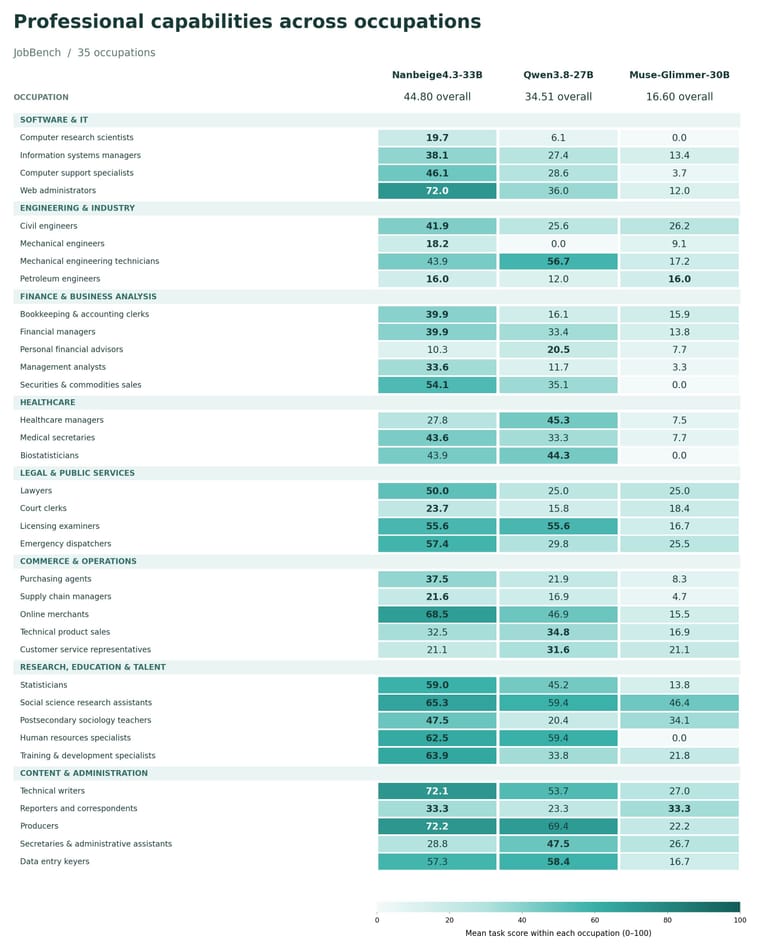
- JobBench: ציון 44.8, לעומת 34.5 של Qwen3.8-27B.
- DeepPlanning: ציון 63.3, לעומת 49.2 של Qwen3.8-27B.
- GPQA Diamond: ציון 89.5.
- AIME 2026: ציון 95.2.
בסך הכול, המודל מוביל ב-17 מתוך 20 המדדים שהציג הצוות, וב-18 מתוכם הוא עוקף את Qwen3.8-27B.
חשוב לציין כי מדובר במדדים שפרסמו המפתחים, וטרם פורסמו בדיקות עצמאיות מקיפות המאמתות את התוצאות.
זמינות:
המודל שוחרר במשקלים פתוחים תחת רישיון Apache 2.0, המאפשר גם שימוש מסחרי.זמינות שתי גרסאות רשמיות - גרסת Instruct עם יכולות חשיבה והפעלת כלים, וגרסת Base המיועדת לאימון ולהתאמות נוספות.
קיימת תמיכה בהרצה באמצעות Transformers, vLLM ו-SGLang, וכבר פורסמו גם גרסאות GGUF קהילתיות להרצה מקומית באמצעות llama.cpp ותוכנות תואמות.
בשל ארכיטקטורת ה-Dense, המודל דורש כ-20GB לאחסון המשקלים בכימות Q4, בנוסף לזיכרון הדרוש לחלון ההקשר.
קישורים:
- כרטיס המודל הרשמי והמדדים:
https://huggingface.co/Nanbeige/Nanbeige4.3-33B - גרסת Base:
https://huggingface.co/Nanbeige/Nanbeige4.3-33B-Base - גרסאות GGUF בכימותים שונים:
https://huggingface.co/AtomicChat/Nanbeige4.3-33B-GGUF
-
מאחר ובכל פעם שיוצא מודל או כלי AI חדש, או עדכון כלשהו למודל קיים מייד תוך כמה שעות מישהו ידאג להעלות נושא חדש עם ציטוט ארוך מאתר טכנולוגיה מזדמן המבשר באריכות על השקת המודל ויכולותיו, חשבתי פשוט ליצור נושא מתעדכן שבו יוכלו המשתמשים להעלות פוסטים קצרים ומתומצתים אודות המודלים החדשים והעדכונים, כך שכל המידע יהיה מרוכז במקום אחד, בקצרה ללא צורך לצטט כתבות שלמות כדי להצדיק פתיחת נושא חדש, ובכך למנוע הספמה של הפורום, כשלעיתים נפתחים במקביל 3 ויותר נושאים המבשרים על השקת מודל חדש...
נא לא להגיב על פוסטים אלא להעלות אך ורק עדכוני AI על מודלים וכלים חדשים וכדומה, בניסוח אנושי ומתומצת בלבד, בלי לפתוח דיונים.
מומלץ להגדיר את הנושא "במעקב" כדי להתעדכן מייד על כל פוסט שעולה. -
Liquid AI • LFM3
חברת Liquid AI משחררת את LFM3, הדור השלישי של מודלי השפה שלה, הכולל הפעם סדרה של שישה מודלים קטנים בתחומי הטקסט, הראייה, האודיו וקבלת ההחלטות.
הסדרה מבוססת על ארכיטקטורה חדשה ומשופרת, וכוללת מודלים בגודל של כ-2B פרמטרים בלבד, המיועדים להרצה מקומית מהירה בטלפונים, במחשבים ובמכשירי קצה, לצד אפשרויות התאמה ואימון למשימות ייעודיות.
המודלים החדשים:
- LFM3-1.7B: מודל טקסט עם חלון הקשר של 256K טוקנים, המיועד במיוחד להפעלת סוכנים, שימוש בכלים ומשימות אוטומציה.
- LFM3-VL-2B: מודל ראייה ושפה להבנת תמונות, וידאו, מסמכים ויחסים מרחביים, עם יכולות Reasoning.
- LFM3-Audio-2B: מודל אודיו התומך בזיהוי דיבור, יצירת קול, תרגום והבנת הקלטות ב-18 שפות, כולל שיחות קוליות בזמן אמת והפעלת כלים.
- LFM3-Omni-2B: מודל מולטימודלי משולב המסוגל לעבד טקסט, תמונות, וידאו ואודיו יחד, ולייצר תשובות בטקסט או בדיבור. זהו מודל ה-Omni הראשון של החברה.
- d1-2B: מודל ייעודי לקבלת החלטות על בסיס טקסט, תמונות ווידאו, המסוגל להחזיר סיווגים, הסתברויות, נתונים מובנים ואיתור עצמים, ללא יצירת טוקנים.
- d1-Omni-2B: גרסה של מודל ההחלטות התומכת גם באודיו, ומאפשרת לנתח בקשות קוליות ולקבל החלטות במהירות גבוהה במיוחד.
עיקרי החידושים:
- ארכיטקטורת Tri-Hybrid: שילוב חדש של Convolution, Sliding Window Attention ו-Global Attention. מתוך 24 שכבות המודל, 13 הן שכבות Convolution, חמש שכבות SWA ושש שכבות Attention מלאות. המבנה נועד לשפר את הביצועים תוך שמירה על צריכת זיכרון נמוכה.
- יכולות גבוהות יותר במודל קטן יותר: גרסת הטקסט החדשה מציגה ביצועים טובים יותר מ-LFM2.5-2.6B, למרות שהיא כוללת כ-35% פחות פרמטרים.
- אימון נרחב: מודל הבסיס אומן על 22 טריליון טוקנים, כולל קוד, מתמטיקה, מידע מדעי ומשימות סוכניות. בהמשך בוצעו שלבי אימון נוספים שכללו RL והעברת יכולות ממודלים מומחים.
- אופטימיזציה להרצה מקומית: מודל הטקסט דורש כ-1GB בלבד בכימות 4 ביט. החברה ביצעה אופטימיזציות למגוון מכשירים, כולל טלפונים, מחשבים ניידים, מעבדי CPU ומאיצי NPU.
- מקודדי ראייה ואודיו חדשים: מודל הראייה כולל מקודד תמונה עצמאי חדש שדורש פחות כוח חישוב, ומודל האודיו מבוסס על מקודד ו-Codec חדשים שפיתחה החברה.
- התאמה אישית: כל ששת המודלים מבוססים על אותה ליבת LFM3-1.7B, והחברה מאפשרת לבצע Fine-tuning למודלים באמצעות GPU יחיד.
מדדים:
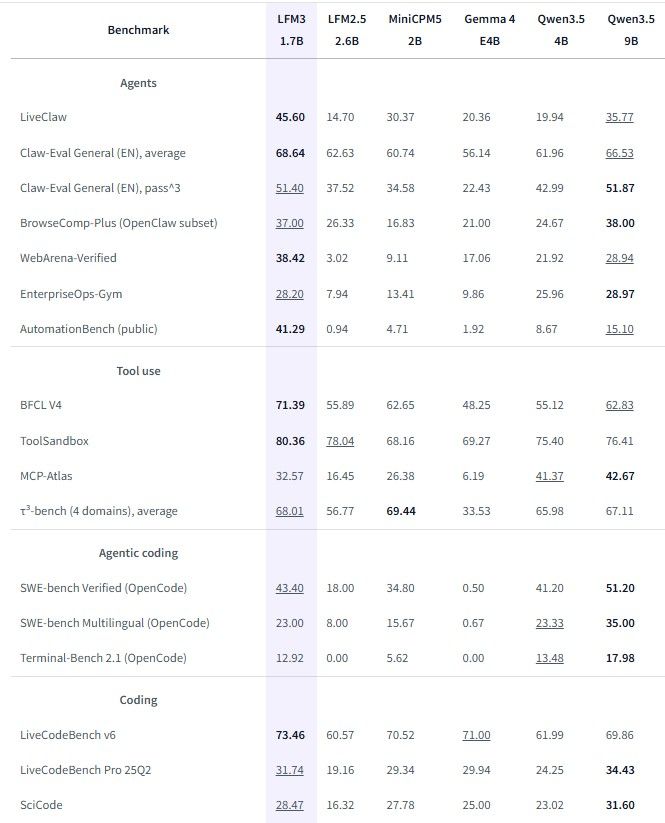
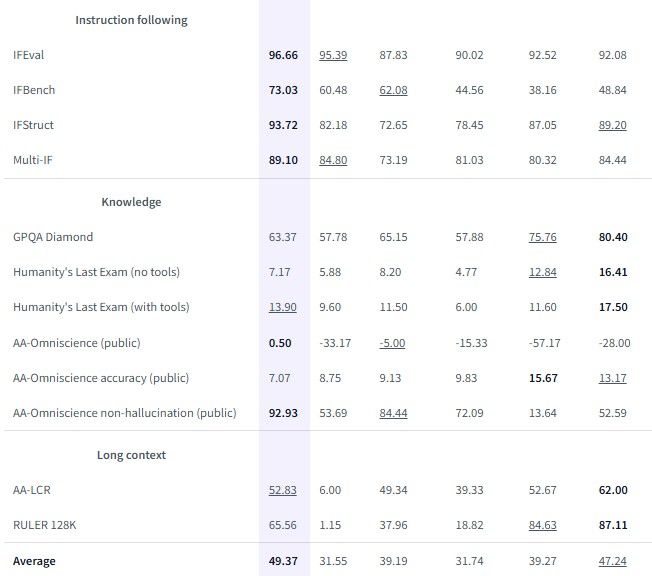
על פי הבדיקות שפרסמה Liquid AI, המודלים החדשים מציגים שיפורים משמעותיים בהשוואה לדור הקודם ולמודלים מתחרים.- LFM3-1.7B: מציג יתרון על Qwen3.5-9B בחלק ממדדי הסוכנים, בהם AutomationBench ו-WebArena-Verified, למרות הפער הגדול בגודל. בבדיקות הרצה מקומית, מהירות יצירת הטוקנים גבוהה פי 1.8 עד 2.8 מהמודלים שנבדקו מולו.
- LFM3-VL-2B: משיג ממוצע 71.4 ב-62 מבחני ראייה, לעומת 57.6 לדור הקודם. לדברי החברה, הוא משתווה בביצועיו ל-Gemma 4 12B, למרות שהוא קטן ממנו ביותר מפי שישה.
- d1-2B: משיג ציון 85.2 ב-Decision Bench לעומת 83.6 בדור הקודם, וציון 75.5 ב-ImajevBench לעומת 64.
- LFM3-Audio-2B: מציג שיפור באיכות הדיבור ובהבנת אודיו לעומת LFM2.5-Audio, עם תמיכה מורחבת ב-18 שפות.
במבחני מהירות שערכה החברה, מודל הטקסט גם הציג צריכת זיכרון נמוכה במיוחד: חלון הקשר של 128K דורש כ-1.6GB של KV Cache, לעומת 4.3GB ב-Qwen3.5-4B.
זמינות:
כל ששת המודלים שוחררו במשקלים פתוחים תחת רישיון LFM Open License 1.0, עם אפשרות להתאמה אישית ולהרצה מקומית.כבר ביום ההשקה זמינות גרסאות GGUF רשמיות למודלי הטקסט, הראייה, האודיו וה-Omni, לצד תמיכה ב-llama.cpp, ב-MLX וב-vLLM. לחלק מהמודלים קיימות גם גרסאות ONNX ופורמטים נוספים.
קישורים:
- הודעת השחרור הרשמית והמדדים:
https://www.liquid.ai/blog/lfm3 - סקירה טכנית נוספת ב-Hugging Face:
https://huggingface.co/blog/LiquidAI/lfm3
כרטיסי המודלים והורדות:
-
LFM3-VL-2B:
https://huggingface.co/LiquidAI/LFM3-VL-2B-GGUF -
LFM3-Audio-2B:
https://huggingface.co/LiquidAI/LFM3-Audio-2B-GGUF -
LFM3-Omni-2B:
https://huggingface.co/LiquidAI/LFM3-Omni-2B-GGUF -
d1-Omni-2B:
https://huggingface.co/LiquidAI/d1-Omni-2B -
התנסות במודלים:
https://playground.liquid.ai
-
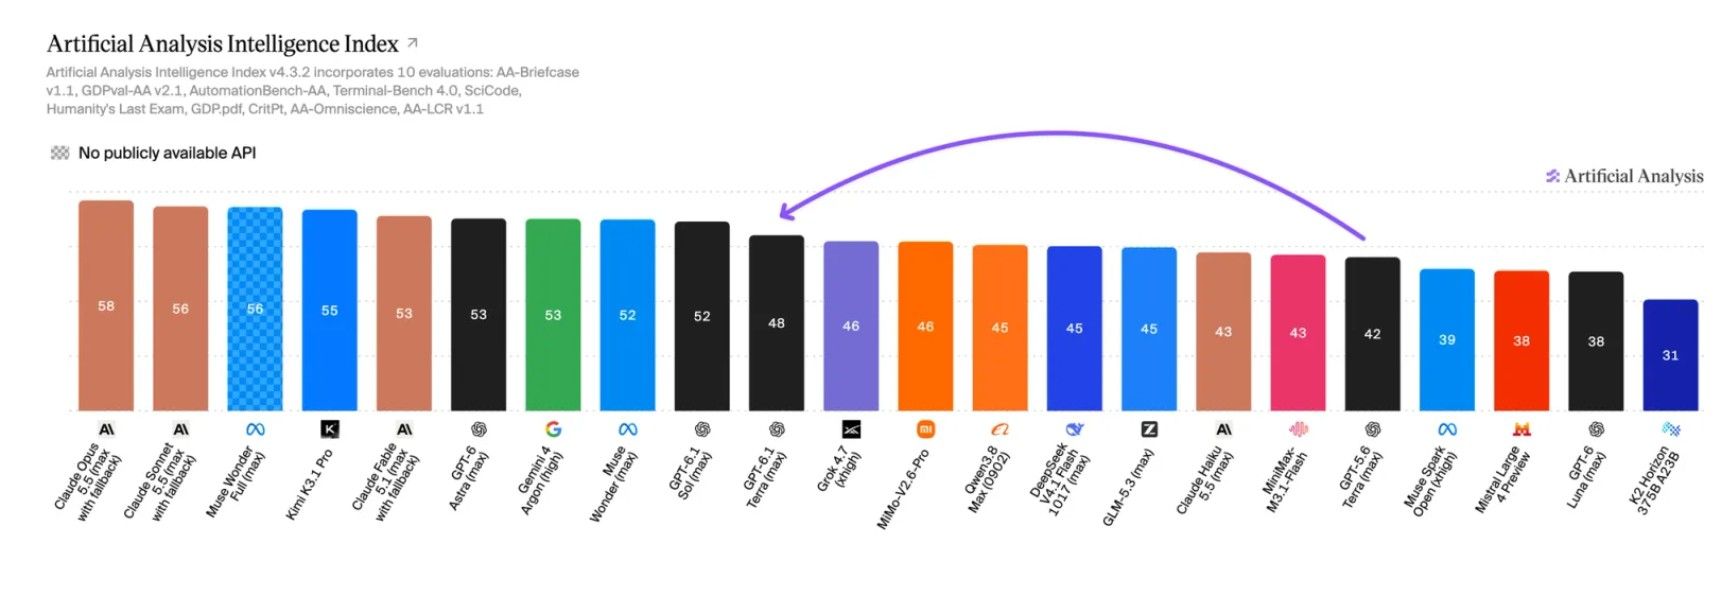
Artifical Analysis עדכנו את המדד שלהם לגרסה 5, מן הסתם בשל כך ש-Kimi K3.1 Pro הסיני דגדג את קלוד 5.5 אופוס בגרסה הקודמת של המדד, ועל הדרך כדי לדחוף עוד כמה מודלים סיניים אחורה.
על הדרך, GPT 6 Astra קיבל פער קצת יותר מחמיא מול קלוד 5.5 אופוס, לעומת Meta Wonder Full שנדחק אחורה משמעותית.
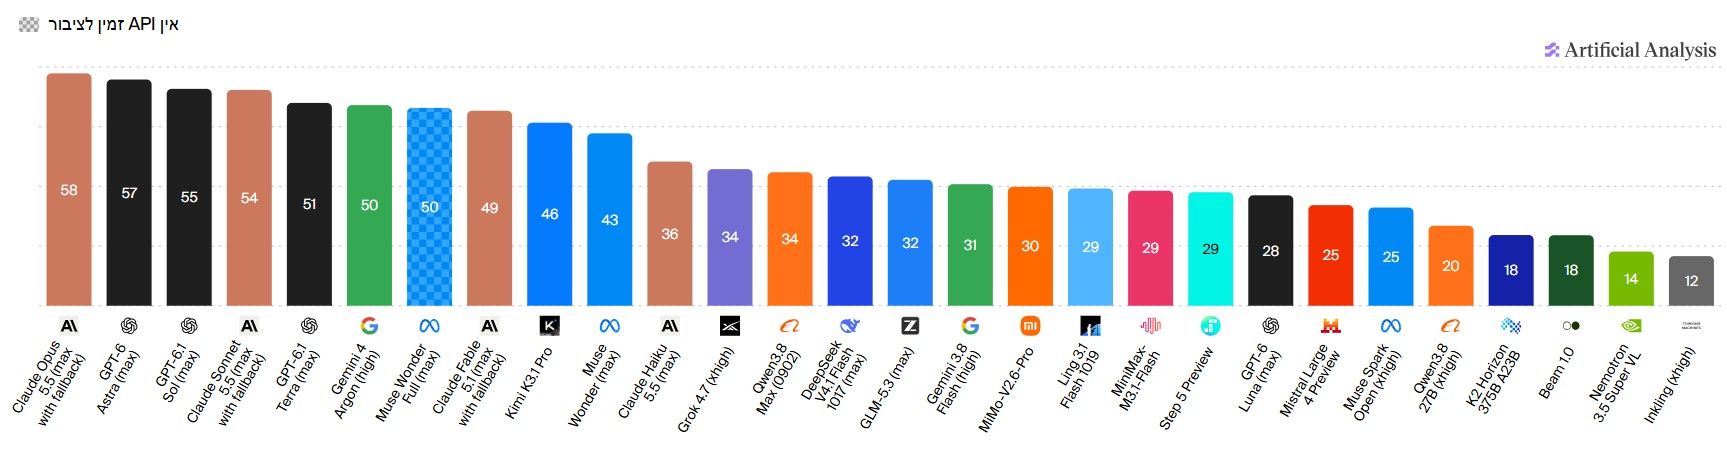
זה רק מזכיר לנו, בקריצה לענייני דיומא, שאסור להסתמך על סקרים, גם אם הם מעוצבים מאוד מאוד יפה...אלא אם כן אתה סוקר בחסד עליון כמו פילבר...
זה לא סותר את העובדה שהמדד הזה יישאר פופולרי בקרב הציבור, בשל פשטותו.
קישורים:
-
בלוג ההכרזה על המדד החדש:
https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5 -
תיעוד המדד החדש:
https://artificialanalysis.ai/methodology/intelligence-benchmarking
-
-
SparkLLM • Spark-X2.6 4B, 1.7B
צוות SparkLLM הסיני משחרר את Spark-X2.6, דור חדש של מודלי שפה קטנים המיועדים להרצה מקומית, בשני גדלים - 4B ו-1.7B.
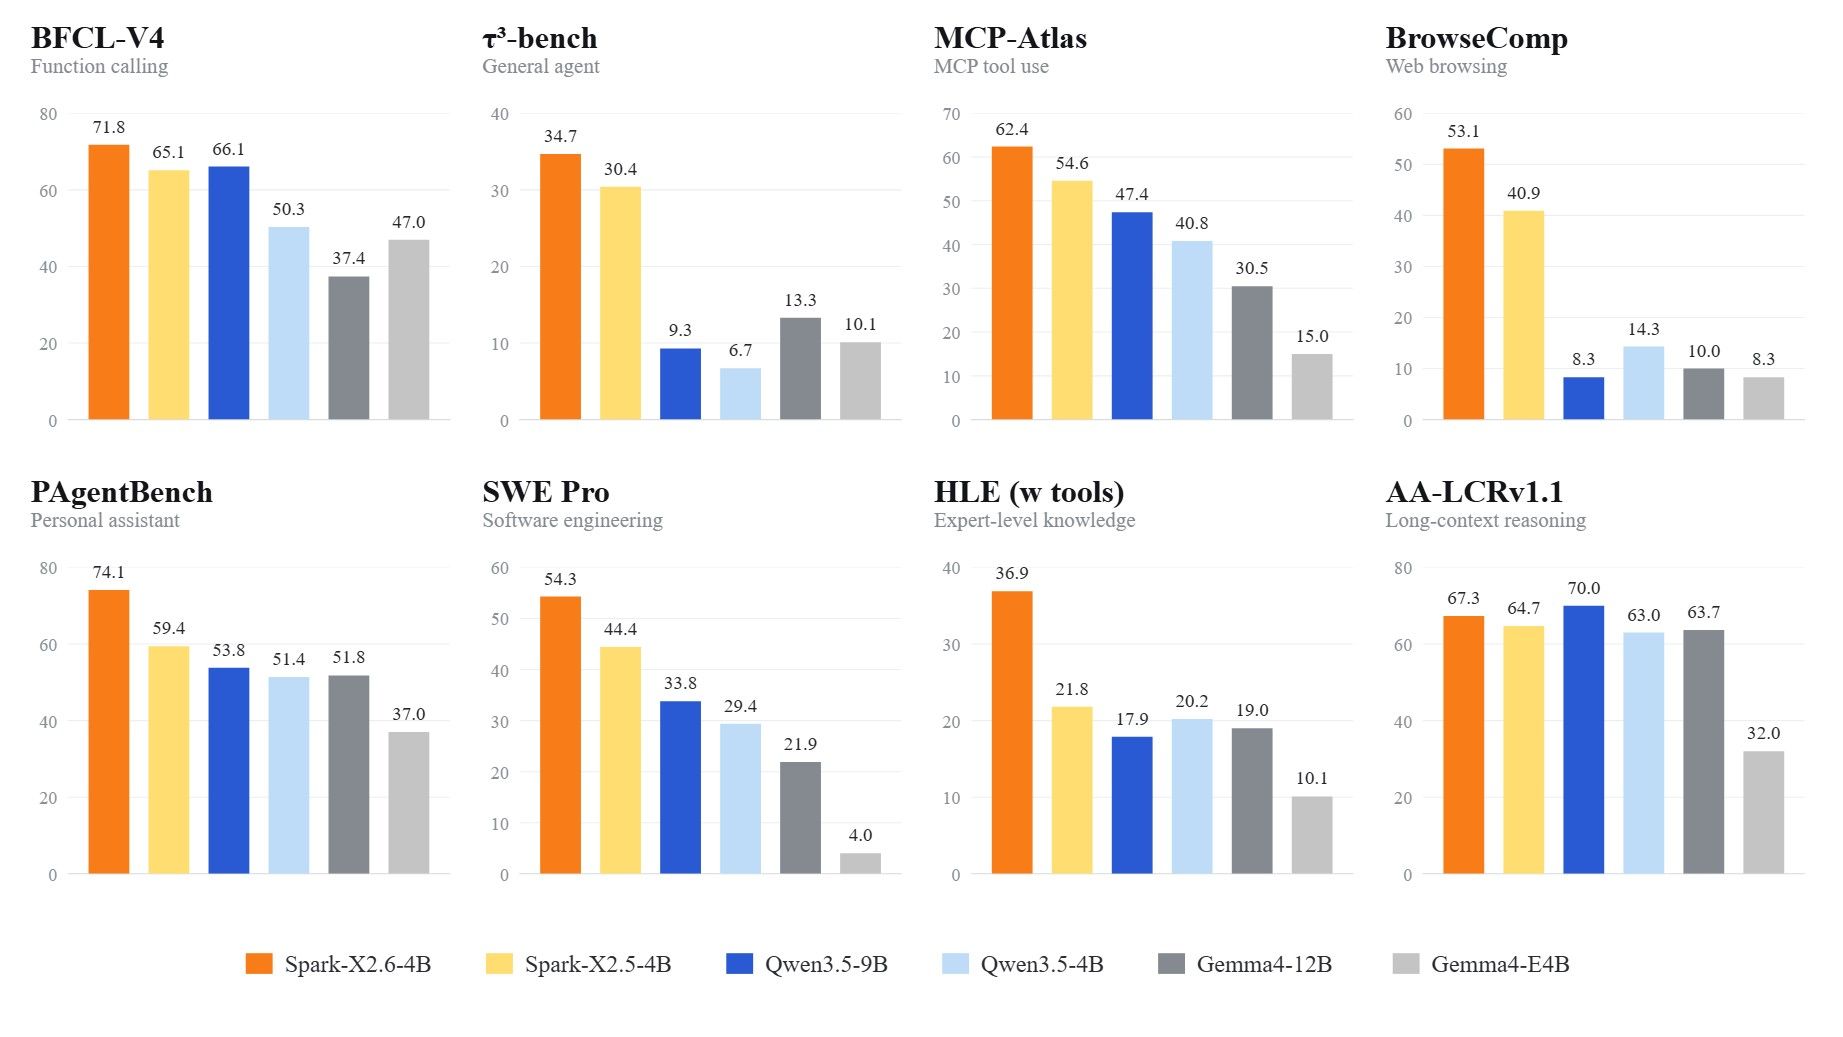
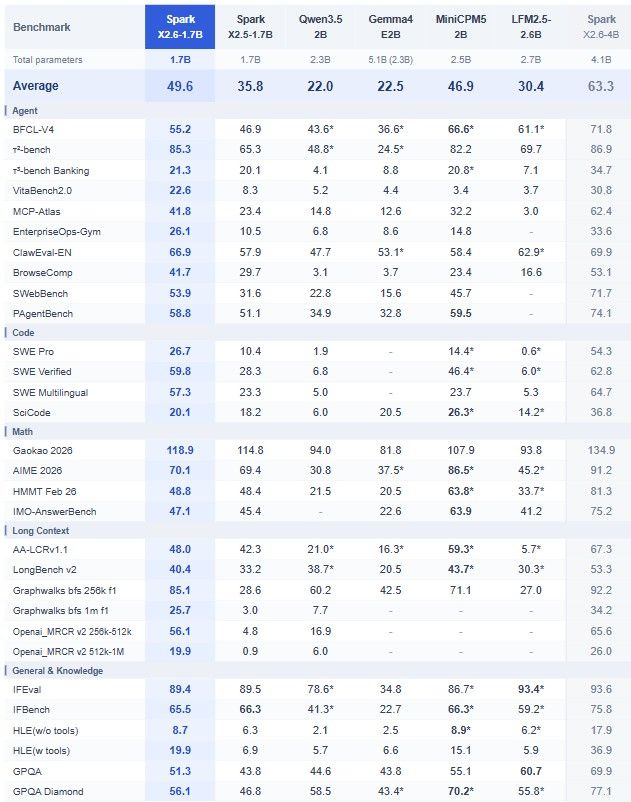
המודלים מציגים שיפור משמעותי ביכולות תכנות, חשיבה והפעלת סוכנים לעומת דור X2.5, כאשר לפי בדיקות המפתחים, גרסת 4B מתחרה בחלק מהמדדים גם במודלים גדולים בהרבה, עד 9B פרמטרים, וגם גרסת 1.7B לא רחוקה ממנה בהרבה.
עיקרי החידושים:
- שלוש רמות חשיבה: תמיכה מובנית ב-Reasoning בשלוש רמות - ללא חשיבה, חשיבה נמוכה וחשיבה גבוהה. ניתן לבחור את הרמה בהתאם למורכבות המשימה, למהירות ולצריכת המשאבים (למיטב ידיעתי אלו המודלים הקטנים ביותר שניתן להתנסות בהם ברמת חשיבה מובנית).
- יכולות סוכן ותכנות: שיפור משמעותי בהפעלת כלים, תכנון מרובה שלבים, עבודה עם קוד וביצוע משימות עצמאיות. המפתחים שמו דגש מיוחד על סוכנים הפועלים ישירות במכשירי קצה.
- חלון הקשר של מיליון טוקנים: תמיכה בהקשרים ארוכים במיוחד, תוך שימוש בארכיטקטורת Attention היברידית המשלבת Sliding Window ו-Full Attention, לצמצום צריכת הזיכרון.
- ארכיטקטורה יעילה: שני המודלים שומרים על הארכיטקטורה של דור X2.5, כאשר השיפורים הושגו בעיקר באמצעות Post-training מתקדם, ללא הגדלת מספר הפרמטרים.
- שיפור בביצועים וביעילות: לפי המפתחים, גרסת 4B מציגה יכולות גבוהות יותר מ-Qwen3.5-4B בחלק ממבחני הסוכנים, תוך יעילות הרצה דומה או טובה יותר.
מדדים:
השיפור בולט במיוחד בגרסת 1.7B, בהשוואה לדור הקודם:- SWE-bench Verified: עלייה מ-28.3 ל-59.8.
- SWE Multilingual: עלייה מ-23.3 ל-57.3.
- τ²-bench: עלייה מ-65.3 ל-85.3.
גם גרסת 4B מציגה שיפור ניכר במדדי תכנות, סוכנים, מתמטיקה, הבנת הקשר ארוך ומעקב אחר הוראות, ולפי המפתחים היא מובילה בין מודלים רבים בגודלה.
- גרסת ה-4B:
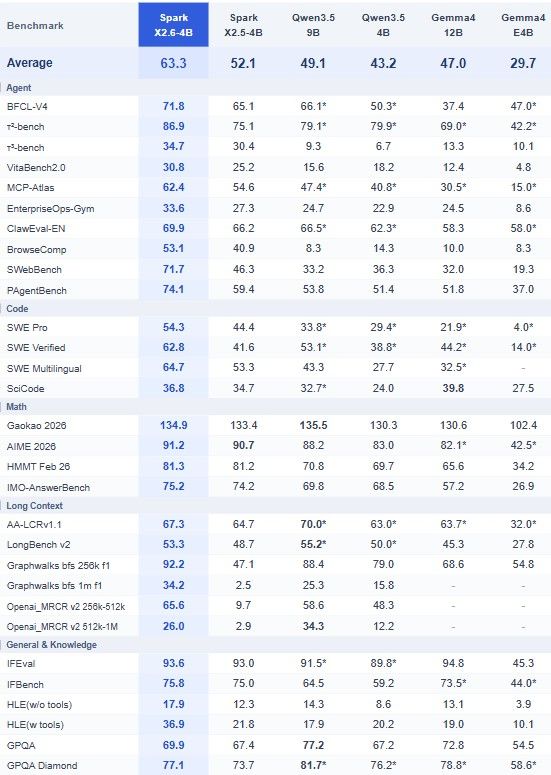
- גרסת ה-1.7B:
זמינות:
שני המודלים שוחררו במשקלים פתוחים תחת רישיון Apache 2.0, המאפשר גם שימוש מסחרי.קיימות גרסאות GGUF רשמיות, עם תמיכה ב-llama.cpp, ב-Ollama וב-LM Studio, לצד אפשרויות הרצה באמצעות Transformers, vLLM, SGLang ו-MLX.
גרסת 4B דורשת כ-2.6GB בכימות Q4_K_M, בעוד גרסת 1.7B מתאימה גם למכשירים בעלי זיכרון מוגבל במיוחד. שימוש בחלון הקשר ארוך מחייב זיכרון נוסף.
קישורים:
- מאגר הפרויקט הרשמי, הסברים ומדדים:
https://github.com/XHToken/Spark-X2.6 - Spark-X2.6-4B - גרסת GGUF רשמית:
https://huggingface.co/XHToken/Spark-X2.6-4B-GGUF - Spark-X2.6-1.7B - גרסת GGUF רשמית:
https://huggingface.co/XHToken/Spark-X2.6-1.7B-GGUF - גרסאות GGUF נוספות של 4B, כולל כימותים חסכוניים יותר:
https://huggingface.co/bartowski/Spark-X2.6-4B-GGUF
-
תכירו את טאב, הסוכן האישי שלכם שיכול לעשות עבורכם כמעט הכל. הוא יכול להתקשר לעסקים, לבנות לכם תוכנות, סתם לברר לכם מה שתצטרכו בשיחה קולית פשוטה, וכמעט בכל דבר שתחשבו עליו.
החלק המעניין ביותר - שהוא חינמי לחלוטין! (לעת עתה, זה נראה שהם מנסים להגיע לקהל יעד גדול ככל האפשר, ואז לעבור לתוכניות מנויים).
יש רשימת המתנה להצטרפות, וכדי להתקדם צריך להזמין חברים (אין לי מושג כמה זמן זה לוקח בלי).
שימו לב שכדי לפתוח אתם חייבים ווטסאפ או SMS! אחר כך אפשר להתכתב איתו גם במייל.
לקישור ההזמנה שלי לחצו כאן
שימוש מועיל!
עריכה: העירו לי שאסור לפרסם קישורים שיש למפרסם רווח מהם, ולכן רציתי להבהיר שכל אחד שמצורף לטאב נכנס לרשימת המתנה, וכדי להתקדם בה צריך לצרף חברים, אפשר אולי לפתוח שרשור יעודי לקישורי הזמנה, וכל אחד יפרסם את הקישור שלו עד שהוא יצורף גם כן.
תודה ל- @לאצי על ההערה. -
Google • Gemini 4 Carbon
גוגל מכריזה רשמית על Gemini 4 Carbon, מודל הדגל החדש והחזק ביותר שלה, כשבועיים בלבד לאחר השקת Gemini 4 Argon.
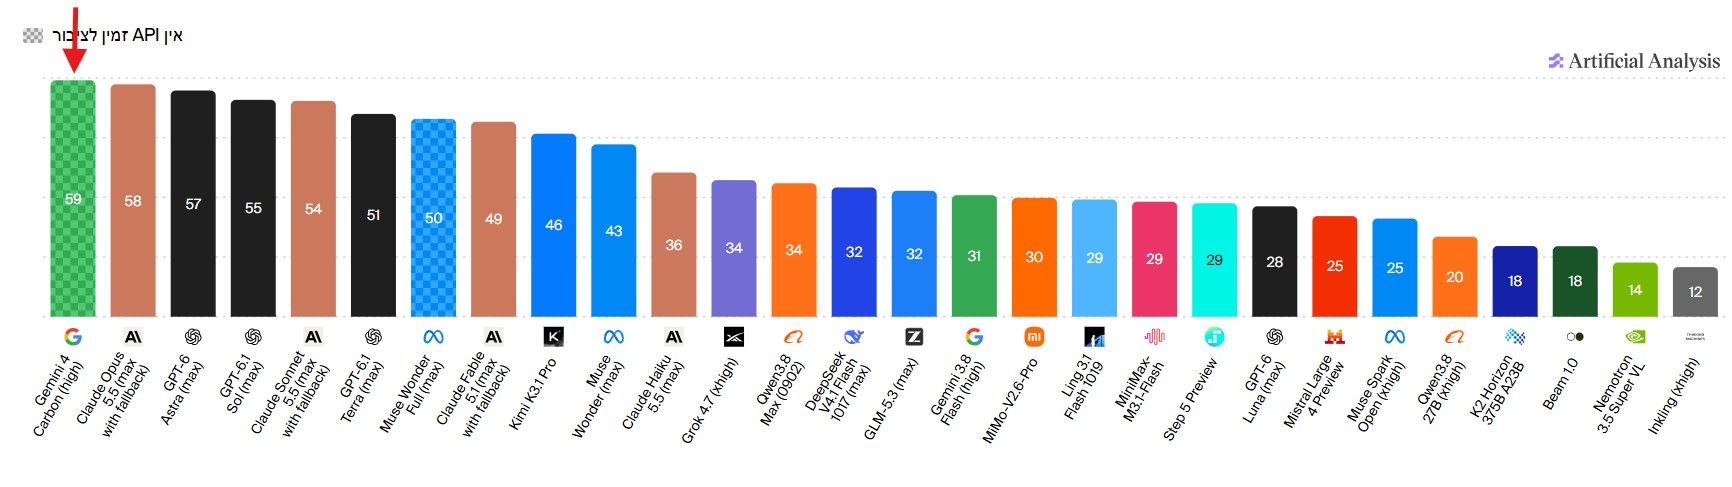
המודל מציג שיפורים משמעותיים בתכנות, חשיבה, הפעלת סוכנים ואבטחת סייבר, וכבר תופס את המקום הראשון בדירוג Artificial Analysis, לפני מודלי הדגל של אנת'רופיק ו-OpenAI.
עיקרי החידושים:
- יכולות סוכן ותכנות: שיפור בביצוע משימות הנמשכות שעות ואף ימים, כולל איתור ותיקון באגים מורכבים, עבודה עם בסיסי קוד גדולים ופיתוח תוכנה באופן עצמאי.
- אבטחת סייבר: יכולות מתקדמות באיתור חולשות, בדיקת אפשרות ניצולן ותיקונן. לפי גוגל, המודל מציג יותר מפי 2 הצלחה ביצירת קוד מאובטח לעומת Argon.
- פיתוח ממשקים: שיפור של 89 נקודות Elo במדד WebDev Arena, הממקם את Carbon במקום הרביעי עם 1,769 נקודות.
- אמינות ודיוק: הפחתה של כ-50% בטענות שאינן מבוססות לעומת Argon, לצד שיפור במעקב אחר הוראות ובהשלמת משימות בלי לחרוג מהבקשה המקורית.
- עמידות בפני Prompt Injection: בבדיקת Gray Swan השיג המודל שיעור הצלחה של 0% לתקיפות שנבדקו, לעומת 0.7% ב-Argon.
מדדים:
המודל הגיע לציון 59 במדד Artificial Analysis Intelligence Index v5, ובכך עקף את Claude Opus 5.5 עם 58 נקודות ואת GPT-6 Astra עם 57 נקודות.במדדי הסייבר שפרסמה גוגל הוא מציג תוצאות מובילות:
- SEC-bench Pro: ציון 88.2% באיתור חולשות אבטחה.
- ExploitGym: ציון 54.8% בבדיקת ניצול חולשות.
- CWE-bench: ציון 71% בתיקון חולשות.
זמינות ומחירים:
בשל יכולות הסייבר המתקדמות, גוגל משחררת את המודל בהדרגה. החל מהשבוע הוא יהיה זמין לקבוצה מצומצמת של מומחי הגנת סייבר, ובהמשך לשותפים נבחרים.גישה ציבורית דרך ה-API, מוצרי גוגל ויישומי Gemini עדיין אינה זמינה, וטרם פורסם מועד השקה מדויק.
התמחור המתוכנן ל-API הוא 2 דולר למיליון טוקני קלט ו-10 דולר למיליון טוקני פלט, עם הנחה של 95% על קלט ממטמון. לאחר תקופת ההשקה המחירים יעלו ל-4 ו-20 דולר בהתאמה.
קישור להכרזה הרשמית ולמדדים:
https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/מפתח אפליקציות אנדרואיד ויישומי ומודלי AI
-
עדכון רלוונטי מאוד:
מחקר מעניין: כותבים ל-AI בעברית? זה עולה לכם עד פי 3 טוקנים
מחקר חושף כיצד האופן שבו מודלי שפה מעבדים טקסט מייקר משמעותית את השימוש בהם. אמ;לק: תעברו לאנגלית.
כשאנחנו משתמשים במודלי שפה גדולים, בין אם דרך הצ'אט או באמצעות API, אתם בטח כבר יודעים שהמנוע מאחורי הקלעים לא קורא מילים כמו בני אדם. במקום זאת, הוא מפרק את הטקסט ליחידות מידע קטנות שנקראות טוקנים, שמשמשות את מעבדות ה-AI גם לצורך תמחור השירותים שלהן.
דוח של קבוצת המחקר CLEAR שופך אור על תופעה, שזכתה לכינוי "מס טוקנים". צוות החוקרים גילה כי מנגנוני הטוקניזציה אומנו בעיקר על אנגלית ושפות בעלות כתב לטיני, ולכן הם מתקשים להתמודד עם שפות אחרות. התוצאה היא שמשפט פשוט יעלה למשתמש בשפות זרות הרבה יותר מאשר למשתמש באנגלית, למרות שהמשמעות או התשובה זהה לחלוטין. כך למשל טקסט באמהרית עלול לדרוש עד פי שישה יותר טוקנים מאשר באנגלית במודל כמו GPT-5.
החוקרים בדקו את יעילות הטוקניזציה של המודלים המובילים בשוק ב-200 שפות שונות. בעוד שב-20 השפות הנפוצות ביותר ברשת הפערים יחסית נסבלים, בשאר השפות הפער יכול לזנק לעד פי 17.
המשמעות עבור המפתחים היא לא רק חשבון ענן מנופח יותר, אלא גם זמני תגובה איטיים יותר ופגיעה בחלון הקונטקסט של המודל – שיכול להכיל פחות מידע לפני שהוא מתחיל לאבד נתונים ולהזות.
נקודה מעניינת בשבילנו, דוברי העברית, שעולה מהמחקר היא המיקום של העברית. למרות הנוכחות הדיגיטלית שלה (מקום 32 בדירוג), במודל Llama 3.3 של מטא, למשל, עלות הטוקנים בעברית תהיה גבוהה פי 3 לעומת טוקנים בעיבוד טקסטים באנגלית – שהיא השפה הזולה ביותר. כלומר, למרות שהעברית פופולרית יחסית, הפעולה של חלק מהטוקנייזרים והמודלים לא יעילה. הנתונים האלו רלוונטיים גם למשתמשים פרטיים, וגם למפתחים בשוק המקומי שלנו.
מבחינת ציונים כוללים, רוב המודלים הגדולים לא מככבים. מודלים של גוגל כמו Gemini 3.8 Flash ו-Gemma 4 זכו לציון סביר יחסית, אך מודלים פופולריים אחרים כמו GPT-5 של חברת OpenAI ו-Command A+ של Cohere קיבלו ציון נכשל עם פערים של כמעט פי 14 בעלויות. מודל התרגום הייעודי NLLB של מטא הוא היחיד שזכה בציון המקסימלי.
החוקרים מסכמים וטוענים שבסופו של דבר מדובר בבחירה הנדסית שניתן לפתור. עד שמעבדות הפיתוח ישנו את הארכיטקטורה שלהן, הפתרון המהיר ביותר לדבריהם הוא מעבר למודל תמחור לפי תווים במקום טוקנים. צעד כזה יבטל את האפליה הכלכלית באופן מיידי, ויאפשר תחרות הוגנת יותר בכלכלה החדשה.
מקור:
https://www.geektime.co.il/ai-tokenizer-tax-cost-llm-hebrew/ -
עדכון רלוונטי מאוד:
מחקר מעניין: כותבים ל-AI בעברית? זה עולה לכם עד פי 3 טוקנים
מחקר חושף כיצד האופן שבו מודלי שפה מעבדים טקסט מייקר משמעותית את השימוש בהם. אמ;לק: תעברו לאנגלית.
כשאנחנו משתמשים במודלי שפה גדולים, בין אם דרך הצ'אט או באמצעות API, אתם בטח כבר יודעים שהמנוע מאחורי הקלעים לא קורא מילים כמו בני אדם. במקום זאת, הוא מפרק את הטקסט ליחידות מידע קטנות שנקראות טוקנים, שמשמשות את מעבדות ה-AI גם לצורך תמחור השירותים שלהן.
דוח של קבוצת המחקר CLEAR שופך אור על תופעה, שזכתה לכינוי "מס טוקנים". צוות החוקרים גילה כי מנגנוני הטוקניזציה אומנו בעיקר על אנגלית ושפות בעלות כתב לטיני, ולכן הם מתקשים להתמודד עם שפות אחרות. התוצאה היא שמשפט פשוט יעלה למשתמש בשפות זרות הרבה יותר מאשר למשתמש באנגלית, למרות שהמשמעות או התשובה זהה לחלוטין. כך למשל טקסט באמהרית עלול לדרוש עד פי שישה יותר טוקנים מאשר באנגלית במודל כמו GPT-5.
החוקרים בדקו את יעילות הטוקניזציה של המודלים המובילים בשוק ב-200 שפות שונות. בעוד שב-20 השפות הנפוצות ביותר ברשת הפערים יחסית נסבלים, בשאר השפות הפער יכול לזנק לעד פי 17.
המשמעות עבור המפתחים היא לא רק חשבון ענן מנופח יותר, אלא גם זמני תגובה איטיים יותר ופגיעה בחלון הקונטקסט של המודל – שיכול להכיל פחות מידע לפני שהוא מתחיל לאבד נתונים ולהזות.
נקודה מעניינת בשבילנו, דוברי העברית, שעולה מהמחקר היא המיקום של העברית. למרות הנוכחות הדיגיטלית שלה (מקום 32 בדירוג), במודל Llama 3.3 של מטא, למשל, עלות הטוקנים בעברית תהיה גבוהה פי 3 לעומת טוקנים בעיבוד טקסטים באנגלית – שהיא השפה הזולה ביותר. כלומר, למרות שהעברית פופולרית יחסית, הפעולה של חלק מהטוקנייזרים והמודלים לא יעילה. הנתונים האלו רלוונטיים גם למשתמשים פרטיים, וגם למפתחים בשוק המקומי שלנו.
מבחינת ציונים כוללים, רוב המודלים הגדולים לא מככבים. מודלים של גוגל כמו Gemini 3.8 Flash ו-Gemma 4 זכו לציון סביר יחסית, אך מודלים פופולריים אחרים כמו GPT-5 של חברת OpenAI ו-Command A+ של Cohere קיבלו ציון נכשל עם פערים של כמעט פי 14 בעלויות. מודל התרגום הייעודי NLLB של מטא הוא היחיד שזכה בציון המקסימלי.
החוקרים מסכמים וטוענים שבסופו של דבר מדובר בבחירה הנדסית שניתן לפתור. עד שמעבדות הפיתוח ישנו את הארכיטקטורה שלהן, הפתרון המהיר ביותר לדבריהם הוא מעבר למודל תמחור לפי תווים במקום טוקנים. צעד כזה יבטל את האפליה הכלכלית באופן מיידי, ויאפשר תחרות הוגנת יותר בכלכלה החדשה.
מקור:
https://www.geektime.co.il/ai-tokenizer-tax-cost-llm-hebrew/




שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות { const baseUrl = "https://www.google.co.il/search?q=site:mitmachim.top"; const m = location.pathname.match(/^\/(topic|category)\/(\d+)/); const type = m ? m[1] : null; const id = m ? m[2] : null; let searchInput; function search(path = "") { const query = searchInput.value.trim(); if (query) { window.open(`${baseUrl}${path}%20${encodeURIComponent(query)}`, "_blank"); } } let buttons = {}; buttons.searchAll = { id: "bb-search-all", label: `חיפוש ${type ? "בכל הפורום" : ""}`, className: type ? "btn-secondary" : "btn-primary", callback: () => search(), }; if (type === "topic") { buttons.searchTopic = { label: "חיפוש בנושא זה", className: "btn-primary", callback: () => search(`/topic/${id}`), }; } else if (type === "category") { buttons.searchCategory = { label: "חיפוש בקטגוריה זו", className: "btn-primary", callback: () => search(`/category/${id}`), }; } buttons.cancel = { label: "ביטול", className: "btn-default", "data-bs-dismiss": "modal" }; const dialog = bootbox.dialog({ title: '<div style="text-align:center;"><img src="/assets/uploads/files/1625950269825-mt-google.png" width="400" alt="חיפוש בגוגל"></div>', message: '<input id="bb-inp" class="bootbox-input bootbox-input-text form-control" placeholder="הקלידו כדי לחפש בגוגל" autocomplete="off"/>', buttons, backdrop: true, show: true, onEscape: true }); dialog.on("shown.bs.modal", function () { searchInput = document.getElementById("bb-inp"); if (searchInput) { searchInput.focus(); searchInput.addEventListener("keydown", function (e) { if (e.key === "Enter") { e.preventDefault(); const query = this.value.trim(); if (query) { search(); dialog.modal("hide"); } } else if (e.key === "Escape") { e.preventDefault(); dialog.modal("hide"); } }); } const searchAllButton = document.getElementById("bb-search-all"); if (searchAllButton) { searchAllButton.title = "לחצו על אנטר כדי לחפש"; } }); })(); void 0;)