
שיתוף | מה חדש בבינה מלאכותית - מתעדכן
-
פוסט זה נמחק!
-
Liquid AI • LFM2.5-24B-A2B
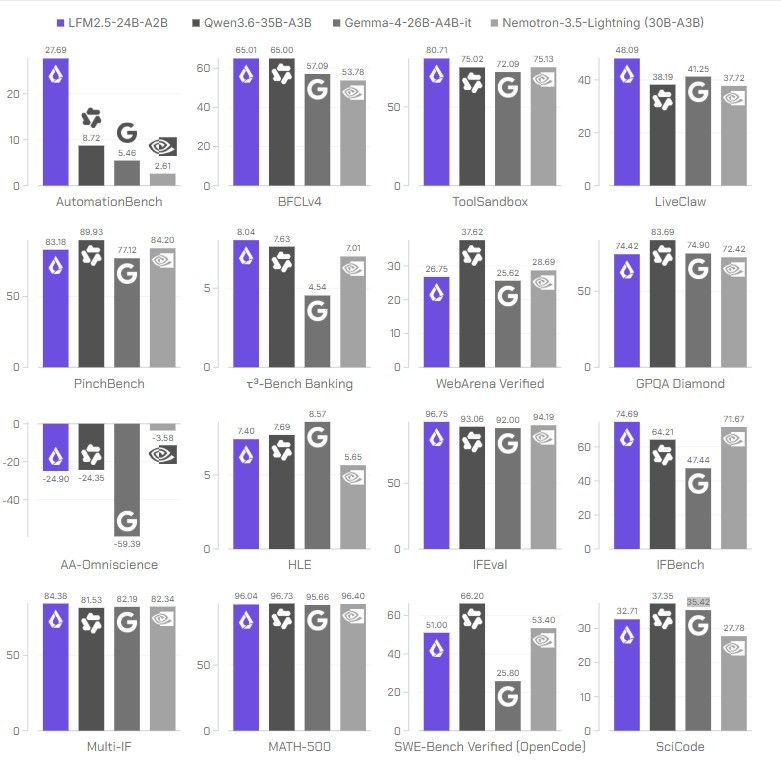
חברת Liquid AI משחררת את LFM2.5-24B-A2B, מודל MoE חדש עם 24 מיליארד פרמטרים, מתוכם כ-2 מיליארד פעילים בכל טוקן. זהו המודל הגדול ביותר בסדרת LFM2.5, והוא פותח במיוחד להרצה מקומית מהירה ולמשימות סוכניות מורכבות.
למרות גודלו, המודל מציג ביצועים תחרותיים מול מודלים גדולים ממנו, בהם Qwen3.6-35B-A3B, תוך צריכת זיכרון נמוכה יותר ומהירות גבוהה במיוחד.
עיקרי החידושים:
- ארכיטקטורה יעילה: שילוב של שכבות Convolution ו-Attention בארכיטקטורת MoE, עם 64 מומחים ו-4 מומחים פעילים בכל שכבת MoE. המבנה מאפשר מהירות גבוהה תוך שמירה על יכולות של מודל גדול.
- יכולות סוכן משופרות: המודל אומן במיוחד להפעלת כלים, מעקב אחר הוראות וביצוע משימות מרובות שלבים, כולל אימון RL בסביבות סוכנים אמיתיות כמו OpenClaw, Hermes Agent ו-OpenCode.
- חשיבה מובנית: בניגוד לדור הקודם, LFM 2, המודל החדש הוא מודל Reasoning שמבצע חשיבה מפורשת לפני מתן התשובה הסופית.
- חלון הקשר מורחב: הגדלה מ-32K ל-131K טוקנים, והרחבת אוצר הטוקנים מ-65K ל-128K לשיפור התמיכה בשפות שונות.
- אימון נרחב: היקף ה-Pre-training הוגדל מ-17 טריליון ל-33 טריליון טוקנים, לצד שלבי אימון נוספים שהתמקדו בתכנות, מתמטיקה, חשיבה ושימוש בכלים.
- מהירות הרצה: על פי בדיקות החברה, המודל מהיר עד פי 1.7 ממודלי MoE מקבילים, עם 184 טוקנים לשנייה על Apple M5 Max ו-114 טוקנים לשנייה על AMD Ryzen AI Max+ 395.
מדדים:
על פי המדדים שפרסמה החברה, המודל מוביל או משתווה למתחריו בחמישה מתוך שמונה מדדי סוכנים והפעלת כלים.ב-LiveClaw השיג ציון 48.09 לעומת 38.19 של Qwen3.6-35B-A3B, וב-AutomationBench השיג 27.69 לעומת 8.72. גם במדדי מעקב אחר הוראות הוא מציג יתרון, אם כי במדדי ידע ותכנות כמו GPQA Diamond ו-SWE-Bench Verified המודלים הגדולים עדיין מובילים.
מדדים:
זמינות:
המודל משוחרר במשקלים פתוחים, לצד גרסת Base המיועדת לאימון והתאמה אישית. הוא זמין כבר כעת להרצה מקומית באמצעות llama.cpp, וכן ב-MLX, vLLM, SGLang ו-ONNX.בנוסף, המודל זמין דרך ה-API של Liquid AI במחיר של 0.10 דולר למיליון טוקני קלט ודולר אחד למיליון טוקני פלט.
קישורים:
- הודעת השחרור הרשמית:
https://www.liquid.ai/blog/lfm2-5-24b-a2b - כרטיס המודל ב-Hugging Face:
https://huggingface.co/LiquidAI/LFM2.5-24B-A2B - גרסת GGUF רשמית:
https://huggingface.co/LiquidAI/LFM2.5-24B-A2B-GGUF - התנסות במודל:
https://playground.liquid.ai
-
"פרסום של גוגל"

 ברייקינג ניוז | Google משיקה את Gemini 4 Aragon
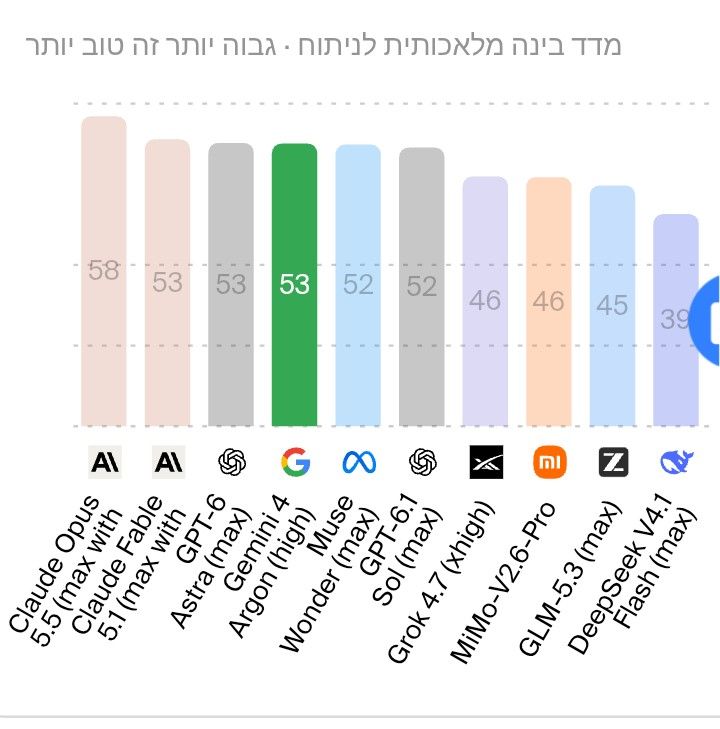
המודל מתמחה במשימות מורכבות בתכנות, פיננסים, משפטים, סייבר ומדע, ועוקף מודלים מתקדמים אחרים במבחני ביצועים. Gemini 4 Aragon זמין מהערב באפליקציית Gemini, פיצ׳ר AI Mode ב-Google ולמפתחים ב-Google Antigravity ו-AI Studio
 הנדסת תוכנה: Aragon ב-Antigravity הגדיל קוד אוטונומי ב-35%+ והפחית שגיאות בשליש. סייע ל-Chrome לקצר משימה של חודשים לכמה שבועות. תהליכים עסקיים: ארגונים כמו Deloitte ו-LexisNexis משתמשים בו למחקר מעמיק, ניתוח דאטה ועיבוד קוד ענק. עם מכסת קלט-פלט של מיליון טוקנים, המודל מנתח ספריות קוד שלמות, שעות וידאו או מאסות של דאטה פיננסי בבת אחת. הגנה בסייבר: אנחנו מרחיבים את תוכנית Fairwind למאות שותפים נוספים, בעקבות הצלחת פיילוט עם Wiz, שהשתמשה ב-Argon כדי לחבר ולתקן פרצות אבטחה קריטיות והגנה על מאות אלפי רשומות רפואיות. פריצות דרך מדעיות: Argon עוזר לחוקרים להגיע לתגליות חדשות כמו הכפלת היעילות של תיקון שגיאות קוונטיות ב-AlphaQubit ומציאת פתרונות מתמטיים חדשים לאנרגיית היתוך נקייה עם חוקרים באוניברסיטת מרילנד. קפיצת מדרגה ברובוטיקה: Argon עוקף את כל שאר המודלים במבחני פיזיקה מרחבית (ERQA) עם ציון של 87%. הוא לומד מיומנות פיזית (כמו קליעה למטרה) רק מצפייה בווידאו גולמי, בונה קוד סימולציה בצורה אוטונומית, ומעביר אותה בהצלחה לרובוט אנושי בעולם האמיתי בתוך שעות.
הבלוג המלא באנגלית עם ויזואליות
 ️
https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/הבלוג המלא בעברית
️
https://docs.google.com/document/d/1Ya2yf-aq9Wiqesw8U16bgVcPzkv9b0hlk5QKYwuT5wM/edit?usp=sharingתיקיית ויזואליות
️
https://drive.google.com/drive/folders/1oTpRM-Sumw2rdEJvbW0iswjbAYu0buLI?usp=sharing -
OpenBMB • MiniCPM-V 4.7
צוות OpenBMB משחרר את MiniCPM-V 4.7, דור חדש של מודלי ראייה ושפה מולטימודליים, המיועדים להבנת תמונות, מסמכים, וידאו וטקסט, עם דגש מיוחד על ביצועים גבוהים בהרצה מקומית ובמכשירים בעלי חומרה מוגבלת.
הסדרה החדשה כוללת שני מודלים:
- MiniCPM-V 4.7 1B: מודל זעיר המיועד בעיקר לטלפונים, למחשבים חלשים ולמכשירי קצה.
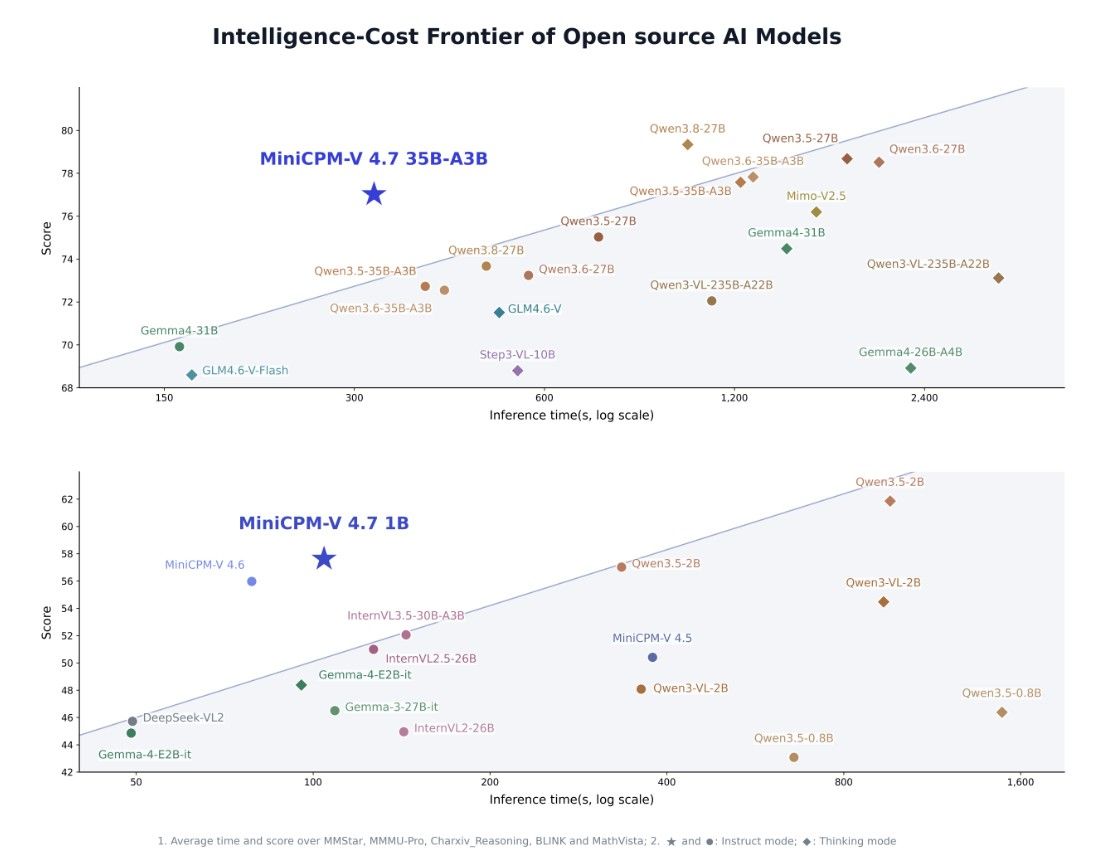
- MiniCPM-V 4.7 35B-A3B: מודל MoE הכולל 35 מיליארד פרמטרים, מתוכם כ-3 מיליארד פעילים בכל טוקן. זהו מודל ה-MoE הראשון בסדרת MiniCPM-V, והוא מיועד לספק יכולות מתקדמות במיוחד תוך שמירה על יעילות בהרצה מקומית.
עיקרי החידושים:
- יכולות מולטימודליות: הבנת תמונות בודדות ומרובות, ניתוח וידאו, זיהוי טקסט בתמונות (OCR), פענוח מסמכים ו-PDF, והבנה מרחבית של עצמים בתמונה.
- עיבוד חזותי יעיל: שימוש בדחיסה מוקדמת של טוקנים חזותיים בתוך מקודד התמונה, עם אפשרות לבחור בין דחיסה פי 4 לפי 16 בהתאם לרמת הפירוט הנדרשת. הטכניקה מפחיתה משמעותית את עומס החישוב.
- הרצת MoE בזיכרון מוגבל: טכניקת Lookahead Expert Scheduling החדשה מאפשרת לחזות אילו מומחים יידרשו בשכבות הבאות ולטעון אותם מראש, בלי לשנות את בחירת המומחים המקורית של המודל או לפגוע בדיוק החישוב.
- האצת יצירת טוקנים: שילוב של קוונטיזציה ברמת שכבות עם Speculative Decoding באמצעות מודלי DSpark ייעודיים, לשיפור המהירות והפחתת הגישה לזיכרון.
- תמיכה רחבה בחומרה: אפשרות להרצה במכשירי Android, iOS ו-HarmonyOS, לצד מחשבים ומעבדים של Intel, AMD ו-Arm.
ביצועים ומדדים:
לדברי המפתחים, גרסת 35B-A3B מציגה ביצועים כוללים טובים יותר מ-Qwen3.6-35B-A3B במצב Instruct, תוך זמן הרצה קצר יותר, ומציעה שילוב תחרותי במיוחד של הבנה חזותית, יכולות שפה ויעילות חישובית.אחד ההישגים הבולטים הוא הרצת מודל 35B-A3B על iPhone 17 Pro Max במהירות של למעלה מ-13 טוקנים לשנייה, תוך שימוש בכ-3GB של זיכרון פעיל, באמצעות אופטימיזציות הטעינה וההרצה החדשות.
מדדים:
זמינות:
שני המודלים משוחררים במשקלים פתוחים תחת רישיון Apache 2.0, עם גרסאות GGUF רשמיות ותמיכה ב-llama.cpp, Ollama, vLLM ו-SGLang. זמינות גם גרסאות קוונטיזציה נוספות, כולל AWQ, GPTQ ו-FP8.קישורים:
-
מאגר הפרויקט ב-GitHub:
https://github.com/OpenBMB/MiniCPM-V -
MiniCPM-V 4.7 1B:
https://huggingface.co/openbmb/MiniCPM-V-4.7-1B-gguf -
MiniCPM-V 4.7 35B-A3B:
https://huggingface.co/openbmb/MiniCPM-V-4.7-35B-A3B-gguf -
בלוג ההשקה:
https://openbmb.cn/en/model/minicpm-v-4-7 -
התנסות במודלים:
https://huggingface.co/spaces/openbmb/MiniCPM-V-4.7-Demo
-
NVIDIA • Nemotron 3.5 Bolt 74B-A9B ו-E4B
אנבידיה מכריזה על שני מודלים חדשים בסדרת Nemotron 3.5 Bolt, המיועדים להרצה מקומית יעילה. הראשון הוא מודל MoE גדול המותאם להפעלת סוכני AI, והשני הוא מודל קטן במיוחד המיועד לדמויות אינטראקטיביות במשחקים.
שני המודלים:
- Nemotron 3.5 Bolt 74B-A9B: מודל הכולל 74 מיליארד פרמטרים, מתוכם 9 מיליארד פעילים בכל טוקן. המודל פותח במיוחד להפעלת סוכנים מקומיים, עם דגש על איזון בין יכולות גבוהות, מהירות תגובה וצריכת זיכרון.
- Nemotron 3.5 Bolt E4B: מודל קטן המיועד בעיקר להפעלת דמויות AI במשחקי מחשב באמצעות NVIDIA ACE, עם יכולות שיחה ואינטראקציה בזמן אמת. גרסתו המיועדת להפצה תופסת כ-4GB בלבד.
עיקרי החידושים:
- קוונטיזציה מתקדמת: גרסת 74B נדחסת ל-24GB בלבד באמצעות קוונטיזציה של 2 ביט, בשילוב Quantization-Aware Training שנועד לצמצם את אובדן הדיוק. מדובר בנפח קטן במיוחד למודל בגודל כזה.
- אופטימיזציה לסוכנים: גרסת A9B פותחה עבור סוכנים המבצעים משימות מורכבות באופן מקומי, תוך ניסיון לשלב את היכולות של מודלים גדולים עם מהירות גבוהה יחסית.
- יחס ביצועים לזיכרון: לפי NVIDIA, מודל A9B נועד להיות מהיר יותר ממרבית מודלי ה-Dense הנפוצים, ובעל יכולות גבוהות יותר ממודלי MoE רבים הדורשים נפח זיכרון דומה.
- הרצה מקומית: כבר עם שחרורו צפויה תמיכה ב-llama.cpp, ב-LM Studio, ב-Ollama וב-vLLM, לצד שילוב בסוכנים כמו OpenClaw ו-Hermes.
- קוד פתוח: NVIDIA מתכננת לפרסם את המשקלים, נתוני האימון ומתכוני האימון של מודל A9B, ולאפשר למפתחים לבצע התאמות ואימון נוסף לצורכיהם.
זמינות:
מודל 74B-A9B צפוי להשתחרר ב-15 באוקטובר, תחילה עם גרסת 2 ביט בנפח 24GB המותאמת בין היתר למחשבי NVIDIA RTX Spark.מודל E4B צפוי להשתחרר ב-23 באוקטובר, כחלק מהדור השלישי של המודלים הקטנים לפלטפורמת NVIDIA ACE.
בשלב ההכרזה טרם פורסמו מדדי ביצועים מפורטים לשני המודלים.
קישורים:
- הודעת ההכרזה הרשמית של NVIDIA:
https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-software-updates/
הפוסט יעודכן בעז"ה אחרי שחרור המודלים במדדים וקישורים ספציפיים.
-
inclusionAI • Ling 3.1 Flash
צוות inclusionAI של ענקית הטכנולוגיה הסינית Ant Group משחרר את Ling 3.1 Flash, מודל MoE חדש ועוצמתי במיוחד, הכולל 560 מיליארד פרמטרים, מתוכם 25 מיליארד פעילים בכל טוקן.
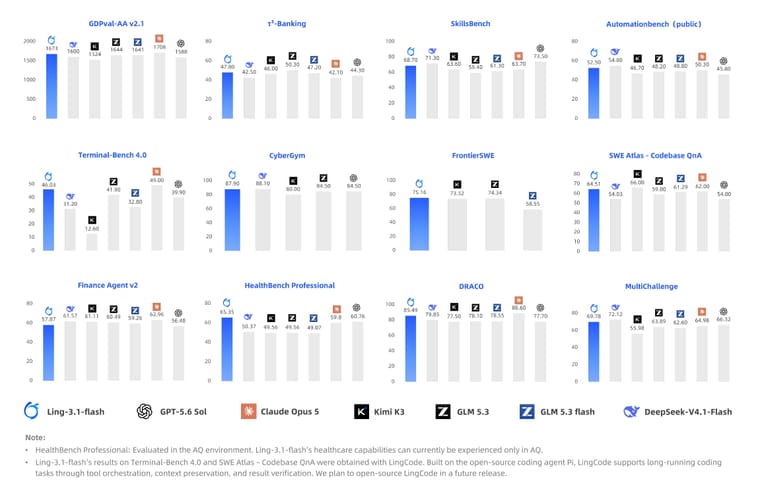
המודל החדש מהווה שדרוג משמעותי לעומת Ling 3.0 Flash, שהכיל 124 מיליארד פרמטרים בלבד, והוא מיועד להתחרות במודלים המובילים במשימות תכנות, חשיבה מורכבת והפעלת סוכני AI.
עיקרי החידושים:
- ארכיטקטורה היברידית: שילוב של Kimi Delta Attention ו-Gated MLA ביחס של 7:1, לצד ארכיטקטורת MoE הכוללת 512 מומחים, שמתוכם 8 מופעלים בכל טוקן. המבנה נועד לאפשר עיבוד יעיל של הקשרים ארוכים תוך צמצום עלויות החישוב.
- חלון הקשר של מיליון טוקנים: הרחבה משמעותית לעומת הדור הקודם, המאפשרת עבודה עם בסיסי קוד גדולים, מסמכים ארוכים ומשימות סוכניות ממושכות. בשירות ה-API הרשמי חלון ההקשר מוגבל כרגע ל-256K טוקנים.
- יכולות סוכן ותכנות: שיפור משמעותי במשימות הדורשות שימוש בכלים, חיפוש מידע, עבודה עם קוד ותכנון מרובה שלבים. המודל נבדק גם בסביבות כמו Claude Code, OpenClaw, Hermes Agent ו-Kilo Code.
- יכולות מקצועיות: שיפורים במשימות משרדיות, במחקר, ברפואה, בפיננסים ובתחומים מדעיים, לצד יכולות חשיבה מתקדמות.
- LingCode: הצוות מציג גם סביבת סוכן תכנות חדשה המבוססת על Pi, עם התאמות למשימות ארוכות הנמשכות שעות וכוללות מאות קריאות לכלים, ניהול הקשר ודחיסתו לאורך העבודה.
- תמיכה ב-Reasoning וב-MTP: אפשרות להפעלה עם חשיבה מפורשת או בלעדיה, לצד תמיכה ב-Speculative Decoding להאצת יצירת התשובות.
מדדים:
על פי המדדים שפרסמו המפתחים, המודל מציג ביצועים תחרותיים במשימות תכנות וסוכנים, בין היתר במבחני Terminal-Bench 4.0, SWE-bench Pro, FrontierSWE, AutomationBench ו-GDPVal-AA V2.1.המודל מציג שיפורים ניכרים לעומת Ling 3.0 Flash, במיוחד במשימות מעשיות הדורשות הפעלת כלים, עבודה עם תוכנות וביצוע תהליכים ארוכים.
זמינות:
המודל שוחרר במשקלים פתוחים תחת רישיון MIT, והוא זמין להורדה ב-Hugging Face. קיימת תמיכה רשמית בהרצה באמצעות SGLang ו-vLLM, עם הוראות הרצה למערכות הכוללות מספר מאיצים גרפיים חזקים.קישורים:
- כרטיס המודל הרשמי והמדדים ב-Hugging Face:
https://huggingface.co/inclusionAI/Ling-3.1-flash - התיעוד הרשמי של סדרת Ling:
https://developer.ant-ling.com/en/docs/models/ling
-
Meta • Muse Spark Open
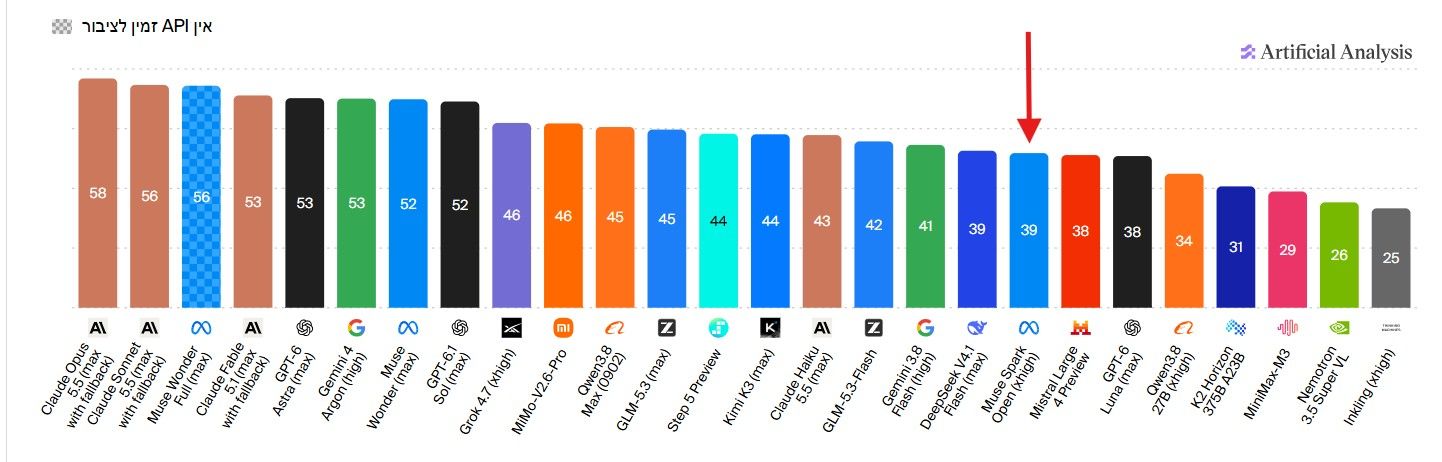
Meta משחררת את Muse Spark Open – מודל MoE ענק ופתוח במשקלים, המתמקד ביכולות סוכניות מתקדמות ובתכנות.
המודל כולל 816B פרמטרים, מתוכם 42B פעילים, חלון הקשר של מיליון טוקנים ותמיכה מולטימודלית בטקסט, תמונות, וידאו ואודיו כקלט (פלט טקסטואלי).
הוא מיועד במיוחד לביצוע משימות ממושכות, שימוש בכלים, עבודה עצמאית על פרויקטי תוכנה, חשיבה מורכבת והפעלת סוכנים.
ביצועים נבחרים לפי נתוני Meta:
- Artificial Analysis Intelligence Index: 39 נקודות.
- MCP-Atlas: 89.2%.
- OSWorld Verified: 80.4%.
- Terminal-Bench 2.1: 76.4%.
המודל מופץ תחת רישיון Muse ייעודי, עם מגבלות מסחריות מסוימות, ולא תחת Apache 2.0.
הרצה מקומית: Meta הכריזה על תמיכה ב-llama.cpp, ב-vLLM, ב-SGLang וב-MLX. בשיתוף Apple הודגמה הרצה על שני מחשבי Mac Studio עם M5 Ultra, ואילו ארבעה מחשבים הגיעו לכ-36.7 טוקנים בשנייה. Unsloth פרסמה גם כימותי GGUF, כולל כימות דינמי של 2 ביט המיועד למערכות עם כ-256GB RAM.
מדדים:
קישורים:
- בלוג ההשקה הרשמי:
https://research.meta.ai/blog/muse-spark-open - כרטיס המודל ב-HF:
https://huggingface.co/unsloth/Muse-Spark-Open-816B-A42B-GGUF
-
NVIDIA • Nemotron Labs Dory 1.0 4B
אנבידיה משחררת את Nemotron Labs Dory 1.0 4B, מודל שפה חדש בעל ארכיטקטורה ניסיונית ומעניינת במיוחד, המאפשרת להגדיל את יכולות החשיבה של המודל באמצעות הקצאת כוח חישוב נוסף, מבלי להגדיל את מספר הפרמטרים או להחליף מודל.
המודל כולל 4B פרמטרים בלבד, אך באמצעות מנגנון חישוב חוזר (Looping) הוא מסוגל להגיע לביצועים של מודלים גדולים משמעותית ממנו.
במילים אחרות, ייתכן שמדובר בהתקדמות ארכיטקטורית עצומה, שמאפשרת חישוב ברמת מודלים גדולים על חומרה חלשה בהרבה, מה שמחזק את יכולות ההיגיון והחשיבה, למרות שהידע הוא אותו ידע (אותו אפשר להגדיל באמצעות טכנולוגיית n-gram שאינה מצריכה זיכרון).
יש לציין, שלפי דיווחים לא רשמיים וחישובים שבוצעו, ייתכן שסדרת GPT 6 פועלת באותו אופן, כשכל מודל בסדרה משתמש במספר אחר של לולאות חישוב על אותו מודל בסיסי. מיקרוסופט (שמריצה את מודלי GPT על שרתי Azure) אישרה ש-GPT 6 משתמש בארכיטקטורה הזו, אך לא אישרה את הדיווח שמדובר באותו מודל יחיד.
עיקרי החידושים:
- ארכיטקטורת Looped LM: במקום להעביר כל טוקן דרך שכבות המודל פעם אחת בלבד, Dory כולל קבוצת שכבות משותפת המופעלת מספר פעמים ברציפות. הארכיטקטורה מורכבת מ-8 שכבות קלט, 20 שכבות חוזרות ו-8 שכבות פלט.
- שליטה בעומק החישוב: ניתן לבחור בין 1, 2 או 4 חזרות על אותן שכבות, בהתאם למורכבות המשימה ולמשאבי המחשב. כך ניתן להגדיל את איכות התשובות בלי לטעון משקלים נוספים לזיכרון.
- חשיבה יעילה יותר: החישוב הנוסף מתבצע בתוך הרשת עצמה, לפני יצירת הטוקן הבא, ולא באמצעות יצירת טוקנים נוספים של Reasoning. לדברי המפתחים, הגדלת מספר החזרות אף מפחיתה את כמות טוקני הפלט הדרושים לפתרון משימות.
- חיסכון בזיכרון: מנגנון Last-Loop KV Cache מאפשר להשתמש באותו KV Cache לאורך כל החזרות, במקום לשמור מטמון נפרד לכל אחת מהן. כך ניתן להגדיל את עומק החישוב כמעט ללא תוספת זיכרון למטמון.
- ארכיטקטורה ואימון: המודל מבוסס על normalized-GPT, עם שילוב של Sliding Window Attention ו-Full Attention. הוא אומן גם באמצעות NVFP4, פורמט ה-4 ביט של NVIDIA, לפני המשך האימון ב-BF16.
- חלון הקשר: תמיכה בעד 256K טוקנים, לצד יכולות Reasoning, שימוש בכלים והפעלת סוכנים.
מדדים:
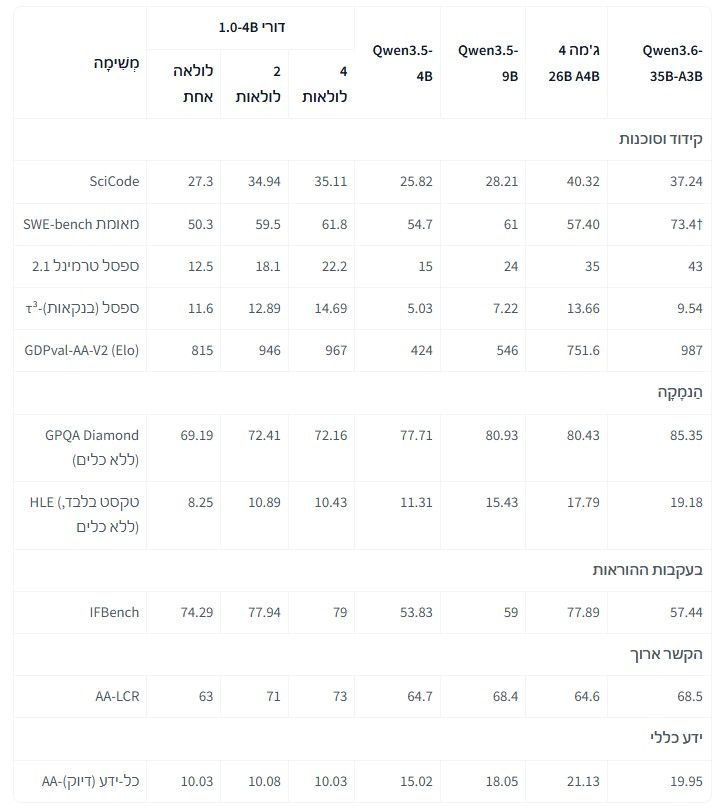
על פי הבדיקות שפרסמה NVIDIA, הגדלת מספר החזרות משפרת משמעותית את ביצועי המודל.ב-SWE-bench Verified הציון עולה מ-50.3 בחזרה אחת ל-59.5 בשתי חזרות ול-61.8 בארבע חזרות, לעומת 61 של Qwen3.5-9B.
ב-IFBench המודל מגיע לציון 79 בארבע חזרות, לעומת 59 של Qwen3.5-9B, ובמבחן AA-LCR להבנת הקשר ארוך הוא מגיע לציון 73, לעומת 68.4 של Qwen3.5-9B ו-68.5 של Qwen3.6-35B-A3B.
עם זאת, במבחנים אחרים כמו GPQA Diamond ו-Terminal-Bench, המודלים הגדולים עדיין מציגים יתרון משמעותי.
זמינות:
המודל שוחרר במשקלים פתוחים תחת רישיון OpenMDW 1.1, המאפשר גם שימוש מסחרי.זמינות גרסאות BF16, MXFP8, NVFP4 ו-GGUF רשמית בכימות Q5_K_M, בנפח של כ-3.67GB.
קיימת תמיכה ראשונית ב-llama.cpp וב-vLLM באמצעות ענפי פיתוח ייעודיים, אך התמיכה עדיין לא שולבה בגרסאות הרשמיות היציבות של התוכנות.
קישורים:
- כרטיס המודל הרשמי והמדדים:
https://huggingface.co/nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 - גרסת GGUF רשמית:
https://huggingface.co/nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-GGUF - בקשת התמיכה ב-llama.cpp:
https://github.com/ggml-org/llama.cpp/pull/30306
שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות { const baseUrl = "https://www.google.co.il/search?q=site:mitmachim.top"; const m = location.pathname.match(/^\/(topic|category)\/(\d+)/); const type = m ? m[1] : null; const id = m ? m[2] : null; let searchInput; function search(path = "") { const query = searchInput.value.trim(); if (query) { window.open(`${baseUrl}${path}%20${encodeURIComponent(query)}`, "_blank"); } } let buttons = {}; buttons.searchAll = { id: "bb-search-all", label: `חיפוש ${type ? "בכל הפורום" : ""}`, className: type ? "btn-secondary" : "btn-primary", callback: () => search(), }; if (type === "topic") { buttons.searchTopic = { label: "חיפוש בנושא זה", className: "btn-primary", callback: () => search(`/topic/${id}`), }; } else if (type === "category") { buttons.searchCategory = { label: "חיפוש בקטגוריה זו", className: "btn-primary", callback: () => search(`/category/${id}`), }; } buttons.cancel = { label: "ביטול", className: "btn-default", "data-bs-dismiss": "modal" }; const dialog = bootbox.dialog({ title: '<div style="text-align:center;"><img src="/assets/uploads/files/1625950269825-mt-google.png" width="400" alt="חיפוש בגוגל"></div>', message: '<input id="bb-inp" class="bootbox-input bootbox-input-text form-control" placeholder="הקלידו כדי לחפש בגוגל" autocomplete="off"/>', buttons, backdrop: true, show: true, onEscape: true }); dialog.on("shown.bs.modal", function () { searchInput = document.getElementById("bb-inp"); if (searchInput) { searchInput.focus(); searchInput.addEventListener("keydown", function (e) { if (e.key === "Enter") { e.preventDefault(); const query = this.value.trim(); if (query) { search(); dialog.modal("hide"); } } else if (e.key === "Escape") { e.preventDefault(); dialog.modal("hide"); } }); } const searchAllButton = document.getElementById("bb-search-all"); if (searchAllButton) { searchAllButton.title = "לחצו על אנטר כדי לחפש"; } }); })(); void 0;)