
עזרה | כל הAI לכתיבת קוד חינם/מגבלה חינמית כאן
-
את הממשק, הוא פשוט נוח ויפה לשימוש. (בתור סתם צ'אט, אולי ביכולות סוכניות LM יעיל יותר..)
מצורף צילום מסך בספויילר:למה זה יותר נוח מהממשק של llama.cpp?
-
מעניין שאני מכיר תוכנה שנותנת מודל סיני ממש חזק בחינם לגמרי ללא מגבלה בתמורה לאימון על הדאטא שלך, ואף אחד לא הביא את זה פה.
-
האם תוכל לפרט?
- בעבר כל החברות הגדולות ששחררו מודלים פתוחים, שחררו גם גרסאות קטנות - 12B ומטה. כיום, החברה היחידה שככל הנראה תמשיך לעשות את זה היא גוגל בשביל המכשירים הניידים. Qwen 4 ככל הידוע לא יכלול גרסאות קטנות, Meta לא שחררה מודל קטן מאז Llama 3.2 העתיק, z.AI לא שחררה מודל קטן מאז GLM 4.6, ושאר המודלים הקטנים שמתפרסמים מידי פעם מגיעים ממעבדות מחקריות וסטארטאפים קטנים נטולי תקציב, וגם אם מידי פעם הם מפתיעים זה לא משהו לבנות עליו.
הסיבה פשוטה - בעבר החברות האלה ניסו למצוא דרך להיכנס לשוק, והדרך הייתה באמצעות המודלים האלו. Meta הייתה צריכה לשבור את הדומיננטיות של OpenAI. Mistral הייתה צריכה לבנות לעצמה שם. Alibaba הייתה צריכה להפוך את Qwen לאקוסיסטם. DeepSeek הייתה צריכה להראות שהיא מסוגלת להתמודד עם המעבדות המערביות. כיום הן כבר נמצאות בצמרת, ואין להן עניין לשחרר מודלים זעירים.
בעבר גם זה מה שהתאפשר להן במסגרת התקציב, כיום הן משקיעות במודלים של טריליוני פרמטרים. - בעבר, השימוש העיקרי ב-AI היה צ'אט פשוט. אז ב-2023 יכולת להסתכל על Llama 2 7B מול GPT-3.5 ולהרגיש שאתה מקבל חלק גדול מהחוויה. ב-2024 הגיעו Llama 3 8B, Qwen2.5 7B, Mistral, Gemma וכו', והפער שוב הצטמצם בצורה מפתיעה. ב-2025 קיבלנו Qwen3, R1 Distills, Gemma 3 וכדומה, והייתה עוד קפיצה.
היום, מודל של 9B לא יכול טכנית להחזיק לולאות סוכן וקידוד מורכב כמו מודלי טריליוני הפרמטרים של היום, ואפילו לא כחוויה מוקטנת, אם זה בגלל מורכבות המשימה ואם בגלל שפער הגדלים בין מודל 7B ישן למודל 300B ישן קטן בהרבה מהפער בין מודל 9B עדכני למודל 2.8T עדכני. אז ה-3B החדש אמנם נהיה טוב יותר מה-3B הקודם, אבל הוא לא סוגר את הפער מול המודלים הגדולים באותו קצב. - בסוף יש תקרת זכוכית כמה מודל של מיליארדי פרמטרים בודדים יכול להחזיק. בעבר מערכי הנתונים היו מאוד מלוכלכים, ושיטות האימון היו ראשוניות מאוד ואפילו מחקריות. כיום כל שורת טקסט שנכנסת לאימון מנופה ומסוננת, ושיטות האימון מתקדמות מאוד, וקשה מאוד להשיג התקדמות משמעותית. זו הסיבה לכך שהחברות הגדולות מעלות עוד ועוד את מספר הפרמטרים של המודלים החדשים, מפני שזו הדרך היחידה נכון לעכשיו לקפוץ קדימה.
- בעבר המודלים הקטנים האלו היו הגדולים ביותר בסדרה שלהם. השחרור שלהם נבע מהאמונה ש-AI צריך להיות בחינם לכל כיס, ולכן החברות התאמצו ככל האפשר כדי לשפר אותם, ולהביא את מירב יכולות ה-AI במודל קטן שרץ על המחשב האישי.
כיום, המודלים הקטנים האלו הם האחים הקטנים ביותר במשפחה עם אחים בני טריליונים, נועדו בעיקר למחקר, להיכנס לשוק באמצעות הוכחת יכולת, לפיצוץ בועת ה-AI המערבית, להפעלת פעולות מסוימות בקצה וסיבות נוספות. הם כבר לא חושבים עלינו עם ה-16 RAM.
אז אני לא אומר שלא יהיו שיפורים - ברור שיהיו, וייתכן שהמודלים הקטנים אפילו יכפילו פי כמה את יכולותיהם, אבל ודאי שזה לא ימשיך להיות בקצב שזה היה עד כה.
מפתח אפליקציות אנדרואיד ויישומי ומודלי AI
- בעבר כל החברות הגדולות ששחררו מודלים פתוחים, שחררו גם גרסאות קטנות - 12B ומטה. כיום, החברה היחידה שככל הנראה תמשיך לעשות את זה היא גוגל בשביל המכשירים הניידים. Qwen 4 ככל הידוע לא יכלול גרסאות קטנות, Meta לא שחררה מודל קטן מאז Llama 3.2 העתיק, z.AI לא שחררה מודל קטן מאז GLM 4.6, ושאר המודלים הקטנים שמתפרסמים מידי פעם מגיעים ממעבדות מחקריות וסטארטאפים קטנים נטולי תקציב, וגם אם מידי פעם הם מפתיעים זה לא משהו לבנות עליו.
-
האם תוכל לפרט?
- בעבר כל החברות הגדולות ששחררו מודלים פתוחים, שחררו גם גרסאות קטנות - 12B ומטה. כיום, החברה היחידה שככל הנראה תמשיך לעשות את זה היא גוגל בשביל המכשירים הניידים. Qwen 4 ככל הידוע לא יכלול גרסאות קטנות, Meta לא שחררה מודל קטן מאז Llama 3.2 העתיק, z.AI לא שחררה מודל קטן מאז GLM 4.6, ושאר המודלים הקטנים שמתפרסמים מידי פעם מגיעים ממעבדות מחקריות וסטארטאפים קטנים נטולי תקציב, וגם אם מידי פעם הם מפתיעים זה לא משהו לבנות עליו.
הסיבה פשוטה - בעבר החברות האלה ניסו למצוא דרך להיכנס לשוק, והדרך הייתה באמצעות המודלים האלו. Meta הייתה צריכה לשבור את הדומיננטיות של OpenAI. Mistral הייתה צריכה לבנות לעצמה שם. Alibaba הייתה צריכה להפוך את Qwen לאקוסיסטם. DeepSeek הייתה צריכה להראות שהיא מסוגלת להתמודד עם המעבדות המערביות. כיום הן כבר נמצאות בצמרת, ואין להן עניין לשחרר מודלים זעירים.
בעבר גם זה מה שהתאפשר להן במסגרת התקציב, כיום הן משקיעות במודלים של טריליוני פרמטרים. - בעבר, השימוש העיקרי ב-AI היה צ'אט פשוט. אז ב-2023 יכולת להסתכל על Llama 2 7B מול GPT-3.5 ולהרגיש שאתה מקבל חלק גדול מהחוויה. ב-2024 הגיעו Llama 3 8B, Qwen2.5 7B, Mistral, Gemma וכו', והפער שוב הצטמצם בצורה מפתיעה. ב-2025 קיבלנו Qwen3, R1 Distills, Gemma 3 וכדומה, והייתה עוד קפיצה.
היום, מודל של 9B לא יכול טכנית להחזיק לולאות סוכן וקידוד מורכב כמו מודלי טריליוני הפרמטרים של היום, ואפילו לא כחוויה מוקטנת, אם זה בגלל מורכבות המשימה ואם בגלל שפער הגדלים בין מודל 7B ישן למודל 300B ישן קטן בהרבה מהפער בין מודל 9B עדכני למודל 2.8T עדכני. אז ה-3B החדש אמנם נהיה טוב יותר מה-3B הקודם, אבל הוא לא סוגר את הפער מול המודלים הגדולים באותו קצב. - בסוף יש תקרת זכוכית כמה מודל של מיליארדי פרמטרים בודדים יכול להחזיק. בעבר מערכי הנתונים היו מאוד מלוכלכים, ושיטות האימון היו ראשוניות מאוד ואפילו מחקריות. כיום כל שורת טקסט שנכנסת לאימון מנופה ומסוננת, ושיטות האימון מתקדמות מאוד, וקשה מאוד להשיג התקדמות משמעותית. זו הסיבה לכך שהחברות הגדולות מעלות עוד ועוד את מספר הפרמטרים של המודלים החדשים, מפני שזו הדרך היחידה נכון לעכשיו לקפוץ קדימה.
- בעבר המודלים הקטנים האלו היו הגדולים ביותר בסדרה שלהם. השחרור שלהם נבע מהאמונה ש-AI צריך להיות בחינם לכל כיס, ולכן החברות התאמצו ככל האפשר כדי לשפר אותם, ולהביא את מירב יכולות ה-AI במודל קטן שרץ על המחשב האישי.
כיום, המודלים הקטנים האלו הם האחים הקטנים ביותר במשפחה עם אחים בני טריליונים, נועדו בעיקר למחקר, להיכנס לשוק באמצעות הוכחת יכולת, לפיצוץ בועת ה-AI המערבית, להפעלת פעולות מסוימות בקצה וסיבות נוספות. הם כבר לא חושבים עלינו עם ה-16 RAM.
אז אני לא אומר שלא יהיו שיפורים - ברור שיהיו, וייתכן שהמודלים הקטנים אפילו יכפילו פי כמה את יכולותיהם, אבל ודאי שזה לא ימשיך להיות בקצב שזה היה עד כה.
אבל הוא לא סוגר את הפער מול המודלים הגדולים באותו קצב.
אני לא מצפה שהוא יסגור באותו קצב את הפער, אבל בהפרש של שנתיים שלוש בהחלט כן.
בסוף יש תקרת זכוכית כמה מודל של מיליארדי פרמטרים בודדים יכול להחזיק. בעבר מערכי הנתונים היו מאוד מלוכלכים, ושיטות האימון היו ראשוניות מאוד ואפילו מחקריות. כיום כל שורת טקסט שנכנסת לאימון מנופה ומסוננת, ושיטות האימון מתקדמות מאוד, וקשה מאוד להשיג התקדמות משמעותית. זו הסיבה לכך שהחברות הגדולות מעלות עוד ועוד את מספר הפרמטרים של המודלים החדשים, מפני שזו הדרך היחידה נכון לעכשיו לקפוץ קדימה.
אותה תקרה קיימת גם במודלי שפה גדולים מעצם העניין של מודלי שפה - שכמה כבר עוד דאטה אתה יכול להכניס. ובסוף ימצאו פטנט חדש שיקפיץ את המודלים (ע"ע 'מהפכת הרזינינג' וטכנולוגית ה'פרמטרים הפעילים') , וממילא מודל קטן בעתיד יכניס בכיס הקטן מודל גדול מסוג אימון של היום.
@א.מ.ד. כתב בעזרה | כל הAI לכתיבת קוד חינם/מגבלה חינמית כאן:
בעבר גם זה מה שהתאפשר להן במסגרת התקציב, כיום הן משקיעות במודלים של טריליוני פרמטרים.
אין עיסוק בקהילת הקוד הפתוח בנושא?
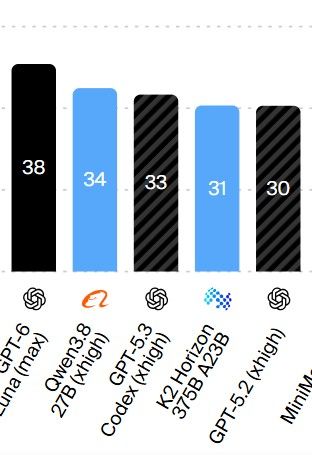
אמנם תטען שזה 27 מילארד פרמטרים - וזה בלתי ניתן לכיווץ , ועדיין זה מדהים, זה אומר שתוך חצי שנה הם הוציאו מודל שיותר טוב מהמודל הסגור הטוב ביותר לקידוד של GPT נכון לחצי שנה לפני. וזה מודל שיכול לרוץ על חומרות דיי פשוטות לפי ערך.
טוב, בעצם לא חידשתי פה כלום (בעניין מירוץ המודלים הקטנים בגדלים של 4 מיליארד פרמטרים), חוץ מזה שיש פה דבר שהוא באמת מפליא.. - בעבר כל החברות הגדולות ששחררו מודלים פתוחים, שחררו גם גרסאות קטנות - 12B ומטה. כיום, החברה היחידה שככל הנראה תמשיך לעשות את זה היא גוגל בשביל המכשירים הניידים. Qwen 4 ככל הידוע לא יכלול גרסאות קטנות, Meta לא שחררה מודל קטן מאז Llama 3.2 העתיק, z.AI לא שחררה מודל קטן מאז GLM 4.6, ושאר המודלים הקטנים שמתפרסמים מידי פעם מגיעים ממעבדות מחקריות וסטארטאפים קטנים נטולי תקציב, וגם אם מידי פעם הם מפתיעים זה לא משהו לבנות עליו.
-
אבל הוא לא סוגר את הפער מול המודלים הגדולים באותו קצב.
אני לא מצפה שהוא יסגור באותו קצב את הפער, אבל בהפרש של שנתיים שלוש בהחלט כן.
בסוף יש תקרת זכוכית כמה מודל של מיליארדי פרמטרים בודדים יכול להחזיק. בעבר מערכי הנתונים היו מאוד מלוכלכים, ושיטות האימון היו ראשוניות מאוד ואפילו מחקריות. כיום כל שורת טקסט שנכנסת לאימון מנופה ומסוננת, ושיטות האימון מתקדמות מאוד, וקשה מאוד להשיג התקדמות משמעותית. זו הסיבה לכך שהחברות הגדולות מעלות עוד ועוד את מספר הפרמטרים של המודלים החדשים, מפני שזו הדרך היחידה נכון לעכשיו לקפוץ קדימה.
אותה תקרה קיימת גם במודלי שפה גדולים מעצם העניין של מודלי שפה - שכמה כבר עוד דאטה אתה יכול להכניס. ובסוף ימצאו פטנט חדש שיקפיץ את המודלים (ע"ע 'מהפכת הרזינינג' וטכנולוגית ה'פרמטרים הפעילים') , וממילא מודל קטן בעתיד יכניס בכיס הקטן מודל גדול מסוג אימון של היום.
@א.מ.ד. כתב בעזרה | כל הAI לכתיבת קוד חינם/מגבלה חינמית כאן:
בעבר גם זה מה שהתאפשר להן במסגרת התקציב, כיום הן משקיעות במודלים של טריליוני פרמטרים.
אין עיסוק בקהילת הקוד הפתוח בנושא?
אמנם תטען שזה 27 מילארד פרמטרים - וזה בלתי ניתן לכיווץ , ועדיין זה מדהים, זה אומר שתוך חצי שנה הם הוציאו מודל שיותר טוב מהמודל הסגור הטוב ביותר לקידוד של GPT נכון לחצי שנה לפני. וזה מודל שיכול לרוץ על חומרות דיי פשוטות לפי ערך.
טוב, בעצם לא חידשתי פה כלום (בעניין מירוץ המודלים הקטנים בגדלים של 4 מיליארד פרמטרים), חוץ מזה שיש פה דבר שהוא באמת מפליא..אין עיסוק בקהילת הקוד הפתוח בנושא?
לקהילת הקוד פתוח אין תקציב, זה מבוסס על מתנדבים, זה לא מגיע לסדרי גודל של אימון מודלים. כשהיה את GPT3 היו עוד אנשים פרטיים שהחליטו ליצור מודלים בקוד פתוח ברמה הזו, כי זאת חומרה שהיה שייך למצוא אנשים שיהיו מוכנים להשקיע בה, אבל במודלים של היום זה פשוט סכומים גבוהים מדי מכדי שמישהו יהיה מוכן לנדב את זה.
-
אין עיסוק בקהילת הקוד הפתוח בנושא?
לקהילת הקוד פתוח אין תקציב, זה מבוסס על מתנדבים, זה לא מגיע לסדרי גודל של אימון מודלים. כשהיה את GPT3 היו עוד אנשים פרטיים שהחליטו ליצור מודלים בקוד פתוח ברמה הזו, כי זאת חומרה שהיה שייך למצוא אנשים שיהיו מוכנים להשקיע בה, אבל במודלים של היום זה פשוט סכומים גבוהים מדי מכדי שמישהו יהיה מוכן לנדב את זה.
-
מעניין שאני מכיר תוכנה שנותנת מודל סיני ממש חזק בחינם לגמרי ללא מגבלה בתמורה לאימון על הדאטא שלך, ואף אחד לא הביא את זה פה.
-
@המלאך סוכן קידוד ברמה הזאת יתן תוצאות טובות?
@א.מ.ד. נשמח לתגובתך איזה מודול אופליין מומלץ לצורך תכנה להפעלת סוכן לקידוד למחשב I7 דור 11 16 גיגה ראם כרטיס מסך מובנה (מסתמא הכי טוב עם SparkMoE)אתה יכול להשתמש ב-Qwen 3.5 9B, או ב-Ornith 1.5 9B שמשדרג אותו מאוד.
לחילופין, אתה יכול להשתמש ב-SparkMoE עם Qwen 3.6 35B A3B, שאמנם חזק בהרבה אבל זה יהיה קצת יותר איטי. אני בניתי אתר שמחקה את חיפוש גוגל עם המודל הזה, וזה לקח לו חצי שעה אבל התוצאה היתה מאוד יפה וכמעט זהה למקור.Qwen 3.6 35B A3B
אני כותב בSparkMoE את המודול Qwen 3.6 35B A3B וזה מביא ממש הרבה אפשרויות הורדה, איזה מהם להוריד?
וגם לאחר בחירה באחת האפשרויות יש הרבה אפשרויות הורדה בגדלים שונים.
אשמח אם תוכל לכוון אותי ספציפיתעריכה: הורדתי אץ Qwen3.6-35B-A3B-UD-Q4_K_M.gguf + mmproj-BF16.gguf
-
-
אגב לא זכור לי שיש אפשרות להורדת מודלים ב-SparkMoE...
תמונה מתוך התכנה (לא אתה יצרת את התכנה? בטח שיש אופצייה להורדה מתוך התכנה עצמה)
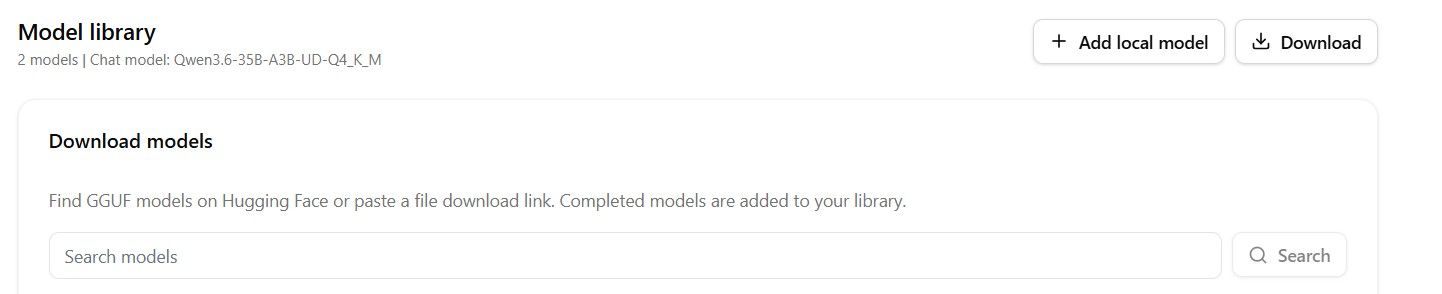
אגב יש אופצייה שסוכן יעבוד ישירות עם SparkMoE? כי כשאני מחבר את OpenCode לOLLAMA עם Qwen3.6-35B-A3B-UD-Q4_K_M.gguf זה פשוט לא זז... (אלא אם כן יש לי בעייה בצורה שחיברתי)
בSparkMoE הצ'אט עובד לאט אמנם אבל עובד
-
אגב לא זכור לי שיש אפשרות להורדת מודלים ב-SparkMoE...
תמונה מתוך התכנה (לא אתה יצרת את התכנה? בטח שיש אופצייה להורדה מתוך התכנה עצמה)
אגב יש אופצייה שסוכן יעבוד ישירות עם SparkMoE? כי כשאני מחבר את OpenCode לOLLAMA עם Qwen3.6-35B-A3B-UD-Q4_K_M.gguf זה פשוט לא זז... (אלא אם כן יש לי בעייה בצורה שחיברתי)
בSparkMoE הצ'אט עובד לאט אמנם אבל עובד
תמונה מתוך התכנה (לא אתה יצרת את התכנה? בטח שיש אופצייה להורדה מתוך התכנה עצמה)
צודק סורי התבלבלתי עם סמארטי. שכחתי אפילו שהכנסתי את האופציה הזאת. אחרי הכל לא כתבתי את זה שורה אחר שורה אלא יחד עם קודקס...
אגב יש אופצייה שסוכן יעבוד ישירות עם SparkMoE? כי כשאני מחבר את OpenCode לOLLAMA עם Qwen3.6-35B-A3B-UD-Q4_K_M.gguf זה פשוט לא זז... (אלא אם כן יש לי בעייה בצורה שחיברתי)
הסיבה שזה לא זז היא שהנחיית המערכת של OpenCode היא בערך 10 אלף טוקנים. על מחשב סטנדרטי עם 16 RAM זה לוקח כמה דקות טובות, ועם מודל גדול עם טכנולוגיית העברת המומחים לדיסק של SparkMoE זה אמור לקחת אף יותר.
אם בכל זאת אתה רוצה לנסות, פשוט תפעיל את SparkMoE ותשנה את כתובת שרת ה-API בתוכנת הסוכן ל-http://127.0.0.1:8080.
ממליץ לך לנסות את מצב שרת מקומי בסמארטי, שתומך ב-"FastMode" - מצב מהיר למודלים מקומיים. משימה קצרה כמו בדיקת מזג אוויר עם מודל כמו Qwen 3.5 4B מסתיימת בהצלחה אחרי כ-5 דקות במחשב הנ"ל. -
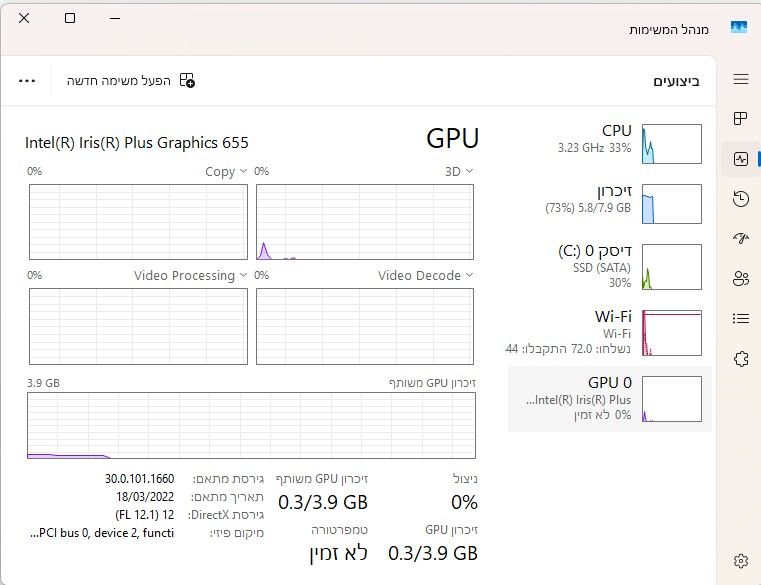
אם זה היכולות של המחשב שלי, מה המודל הכי מומלץ לקוד? ואיך אני מתקין ומשתמש בו? ממש אשמח לקצת עזרה
אם זה היכולות של המחשב שלי, מה המודל הכי מומלץ לקוד? ואיך אני מתקין ומשתמש בו? ממש אשמח לקצת עזרה
אין לך GPU.
8 RAM בלבד.
המקסימום אצלך זה Qwen 3.5 4B לקידוד וסוכן, ו-Gemma 4 E2B (אולי תצליח אפילו E4B, קשה להאמין) לעברית ושימושים כלליים.
עם SparkMoE תוכל להריץ גם מודל חזק כמו Qwen 3.6 35B A3B, אבל הוא יהיה אצלך איטי בהרבה כי אין הרבה RAM למטמון המומחים. אתה יכול גם Ling 3.0 Tiny 8B A1.3B, אבל הוא לא תומך בכלל בעברית.
אם אתה רוצה מודל צעצוע מהיר בעברית, DictaLM 3.0 1.7B.הכי פשוט זה עם LM Studio עם המדריך המעולה של @חובבן-מקצועי (תחפש בהיסטוריית הנושאים שלו), או עם המדריך שלי אם תרצה להעמיק קצת יותר.
אתה יכול גם עם SparkMoE באמצעות הורדת מודל כמו ש-@yolevi הראה בתמונה. תכתוב בחיפוש את אחד המודלים שהמלצתי לך פה. -
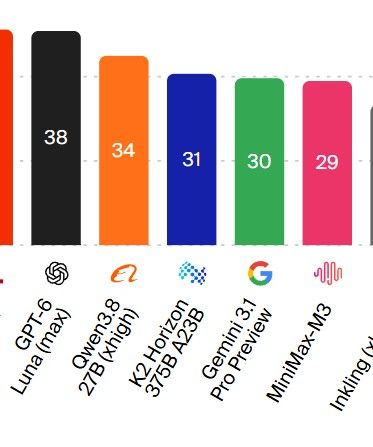
@YOLEVI א"א לדעת, תלוי באופי הפרוייקט, אם היו נותנים לי לבחור בין ג'מיני 3.1 פרו לבין קוואן (שניתן להרצה ביתית) הכי חדש הייתי לוקח את ג'מיני..
-
אם זה היכולות של המחשב שלי, מה המודל הכי מומלץ לקוד? ואיך אני מתקין ומשתמש בו? ממש אשמח לקצת עזרה
אין לך GPU.
8 RAM בלבד.
המקסימום אצלך זה Qwen 3.5 4B לקידוד וסוכן, ו-Gemma 4 E2B (אולי תצליח אפילו E4B, קשה להאמין) לעברית ושימושים כלליים.
עם SparkMoE תוכל להריץ גם מודל חזק כמו Qwen 3.6 35B A3B, אבל הוא יהיה אצלך איטי בהרבה כי אין הרבה RAM למטמון המומחים. אתה יכול גם Ling 3.0 Tiny 8B A1.3B, אבל הוא לא תומך בכלל בעברית.
אם אתה רוצה מודל צעצוע מהיר בעברית, DictaLM 3.0 1.7B.הכי פשוט זה עם LM Studio עם המדריך המעולה של @חובבן-מקצועי (תחפש בהיסטוריית הנושאים שלו), או עם המדריך שלי אם תרצה להעמיק קצת יותר.
אתה יכול גם עם SparkMoE באמצעות הורדת מודל כמו ש-@yolevi הראה בתמונה. תכתוב בחיפוש את אחד המודלים שהמלצתי לך פה.@א.מ.ד. ועם התוכנה שלך להרצת מודלים גדולים, אפשר יותר?
-
@א.מ.ד. ועם התוכנה שלך להרצת מודלים גדולים, אפשר יותר?
פוסט זה נמחק! -
@א.מ.ד. ועם התוכנה שלך להרצת מודלים גדולים, אפשר יותר?
@א.מ.ד. ועם התוכנה שלך להרצת מודלים גדולים, אפשר יותר?
אתה יודע לקרוא?
כתבתי במפורש:א.מ.ד. כתב בעזרה | כל הAI לכתיבת קוד חינם/מגבלה חינמית כאן:
עם SparkMoE תוכל להריץ גם מודל חזק כמו Qwen 3.6 35B A3B, אבל הוא יהיה אצלך איטי בהרבה כי אין הרבה RAM למטמון המומחים. אתה יכול גם Ling 3.0 Tiny 8B A1.3B, אבל הוא לא תומך בכלל בעברית.
-
@א.מ.ד. ועם התוכנה שלך להרצת מודלים גדולים, אפשר יותר?
אתה יודע לקרוא?
כתבתי במפורש:א.מ.ד. כתב בעזרה | כל הAI לכתיבת קוד חינם/מגבלה חינמית כאן:
עם SparkMoE תוכל להריץ גם מודל חזק כמו Qwen 3.6 35B A3B, אבל הוא יהיה אצלך איטי בהרבה כי אין הרבה RAM למטמון המומחים. אתה יכול גם Ling 3.0 Tiny 8B A1.3B, אבל הוא לא תומך בכלל בעברית.
@א.מ.ד. אוקי תודה.
-
@א.מ.ד. ועם התוכנה שלך להרצת מודלים גדולים, אפשר יותר?
אתה יודע לקרוא?
כתבתי במפורש:א.מ.ד. כתב בעזרה | כל הAI לכתיבת קוד חינם/מגבלה חינמית כאן:
עם SparkMoE תוכל להריץ גם מודל חזק כמו Qwen 3.6 35B A3B, אבל הוא יהיה אצלך איטי בהרבה כי אין הרבה RAM למטמון המומחים. אתה יכול גם Ling 3.0 Tiny 8B A1.3B, אבל הוא לא תומך בכלל בעברית.
@א.מ.ד.
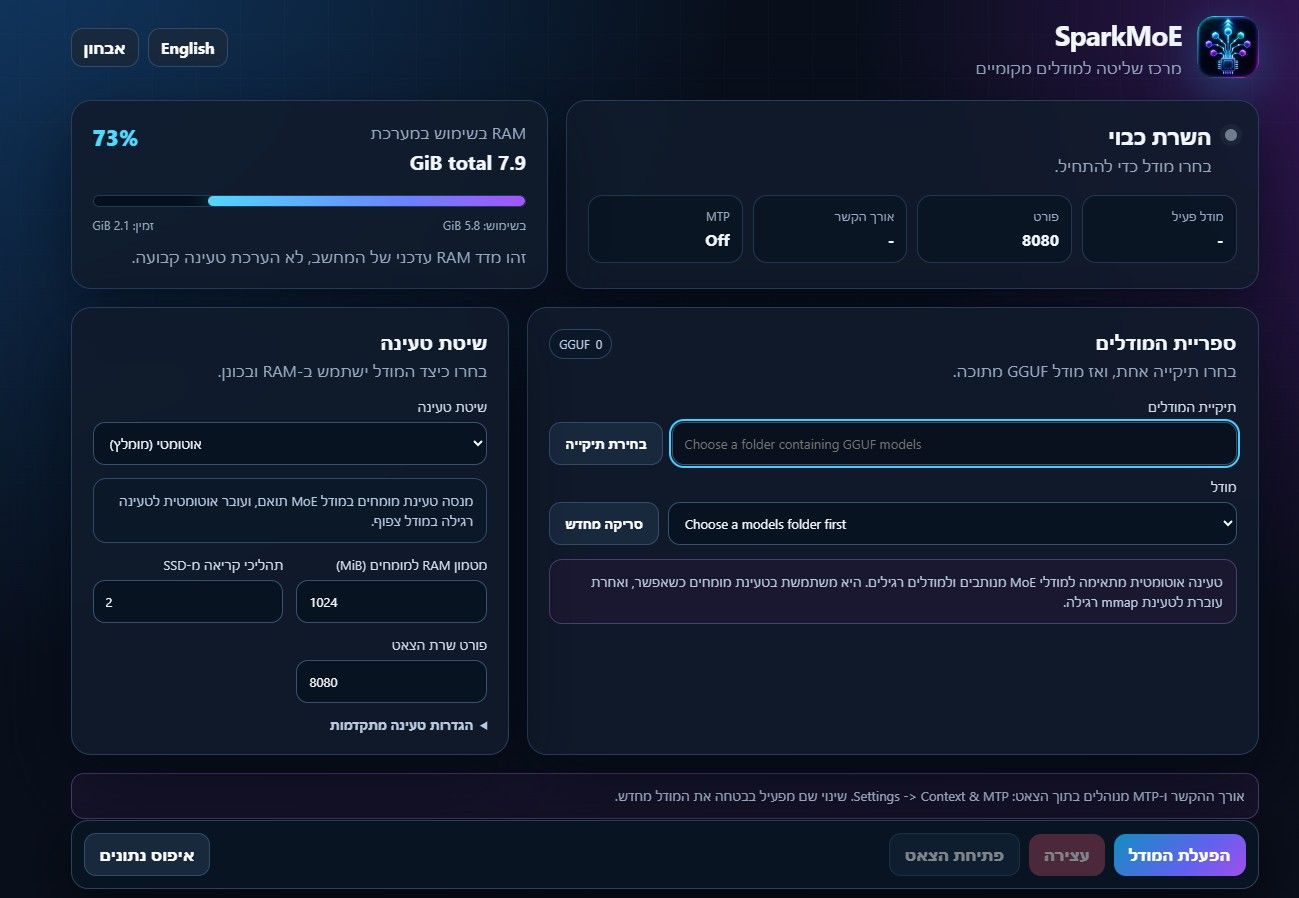
איפה אני משיג מודלים?
וקצת ביררתי, הבנתי שהמודל הכי טוב לקוד שאני יכול להריץ הוא Qwen 2.5 Coder 7B Instruct, אמנם הוא יהיה ממש איטי אבל אני מעדיף איכות על מהירות. אשמח אם תסביר לי איך לחבר אותו לתוכנה ומאיפה להוריד אותו, אני לא ממש מבין בזה...
שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות { const baseUrl = "https://www.google.co.il/search?q=site:mitmachim.top"; const m = location.pathname.match(/^\/(topic|category)\/(\d+)/); const type = m ? m[1] : null; const id = m ? m[2] : null; let searchInput; function search(path = "") { const query = searchInput.value.trim(); if (query) { window.open(`${baseUrl}${path}%20${encodeURIComponent(query)}`, "_blank"); } } let buttons = {}; buttons.searchAll = { id: "bb-search-all", label: `חיפוש ${type ? "בכל הפורום" : ""}`, className: type ? "btn-secondary" : "btn-primary", callback: () => search(), }; if (type === "topic") { buttons.searchTopic = { label: "חיפוש בנושא זה", className: "btn-primary", callback: () => search(`/topic/${id}`), }; } else if (type === "category") { buttons.searchCategory = { label: "חיפוש בקטגוריה זו", className: "btn-primary", callback: () => search(`/category/${id}`), }; } buttons.cancel = { label: "ביטול", className: "btn-default", "data-bs-dismiss": "modal" }; const dialog = bootbox.dialog({ title: '<div style="text-align:center;"><img src="/assets/uploads/files/1625950269825-mt-google.png" width="400" alt="חיפוש בגוגל"></div>', message: '<input id="bb-inp" class="bootbox-input bootbox-input-text form-control" placeholder="הקלידו כדי לחפש בגוגל" autocomplete="off"/>', buttons, backdrop: true, show: true, onEscape: true }); dialog.on("shown.bs.modal", function () { searchInput = document.getElementById("bb-inp"); if (searchInput) { searchInput.focus(); searchInput.addEventListener("keydown", function (e) { if (e.key === "Enter") { e.preventDefault(); const query = this.value.trim(); if (query) { search(); dialog.modal("hide"); } } else if (e.key === "Escape") { e.preventDefault(); dialog.modal("hide"); } }); } const searchAllButton = document.getElementById("bb-search-all"); if (searchAllButton) { searchAllButton.title = "לחצו על אנטר כדי לחפש"; } }); })(); void 0;)